tlooto: 학술 종합과 원고 개발을 위한 근거 기반 에이전트 워크스페이스
tlooto Research Team
초록
배경. 학술 문헌은 매년 약 4%씩 늘어나고, 체계적 문헌고찰 하나에는 전문가의 1년 이상이 투입된다. 대규모 언어 모델(LLM)은 부담을 덜어 줄 것처럼 보이지만, 최신 모델도 생성한 과학 인용의 대부분을 지어내며 검색 기반 상용 도구조차 질의의 최대 3분의 1에서 환각을 보인다.
목적. 본 논문은 연구 질문에 문헌으로 답하고 그 답을 원고로 발전시키되, 모든 인용이 해당 질문을 위해 검색된 학술 문헌을 가리키도록 설계된 연구 워크스페이스 tlooto를 제시한다.
시스템. tlooto는 계획, 학술 검색, 문헌 선별, 근거 종합, 편집을 하나의 에이전트 워크플로로 수행한다. 각 단계는 진행되는 즉시 연구자에게 공개되며, 종합 단계는 선별을 통과한 논문에서만 인용을 가져온다.
기능. 질의응답을 넘어 tlooto는 다섯 가지 인용 스타일로 인용, 표, 그림, 수식을 다루는 논문 형식 에디터, 직접 논문 검색, 개인 라이브러리와 프로젝트 메모리, 저널 추천을 제공하여 아이디어 구상부터 투고까지 연구 전 주기를 지원한다.
의의. tlooto는 인용 신뢰성을 연구자가 사후에 확인해야 하는 문제에서 답이 만들어지는 방식 자체의 속성으로 바꾸며, 새롭게 등장한 연구 에이전트를 일상적인 학술 작업에 맞는 형태로 제공한다.
주제어: 연구 에이전트; 검색 증강 생성; 인용 근거화; 근거 종합; 문헌고찰 자동화; 학술 글쓰기
1. 서론
1.1 문헌의 규모
과학 문헌은 한 세기 넘게 꾸준히 늘어 왔다. Bornmann 등은 현재 증가율을 연 4.10%, 배가 시간을 약 17년으로 추정한다 [1]. 임상의학의 압박은 더 크다. 2010년에 이미 하루 약 75건의 임상시험과 11건의 체계적 문헌고찰이 출판되었다 [2](Figure 1). 이 근거를 손으로 종합하는 일은 느리고 비용이 크다. PROSPERO에 등록된 체계적 문헌고찰은 등록부터 출판까지 평균 67.3주가 걸렸다 [3].
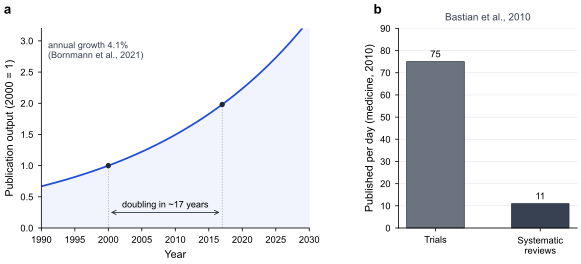
Figure 1. 과학 문헌의 증가. (a) 보고된 연 증가율 4.1%로 모델링한 출판량, 배가 시간 약 17년. (b) 2010년 의학 분야에서 하루에 출판된 임상시험과 체계적 문헌고찰 수.
1.2 연구 현장에 들어온 AI
연구자들은 AI를 도입하는 것으로 대응해 왔다. 1,600명 이상의 과학자를 조사한 Nature 설문에서 과반이 AI 도구가 자기 분야에 매우 중요하거나 필수적이 될 것이라 예상했고 [4], 출판 기록 분석에서는 최근 컴퓨터과학 논문의 최대 17.5%에서 LLM이 수정한 내용이 발견되었다 [5]. 연구 에이전트도 빠르게 뒤따랐다. 과학 지식을 종합하고 [13] [14] [15], 서베이 논문 초안을 쓰며 [16], 전문 심사자가 인간의 아이디어보다 참신하다고 평가한 연구 아이디어를 만들고 [19], 가설을 제안하고 검증한다 [17] [18].
1.3 신뢰성의 간극
그러나 범용 LLM은 어떤 출처로도 뒷받침되지 않는 유창한 진술을 생성하며 [6], 그 실패가 가장 눈에 띄고 비용이 큰 곳이 인용이다. OpenScholar 평가에서 GPT-4o는 생성한 과학 인용의 78~90%를 지어냈다 [15]. 검색만으로는 간극이 닫히지 않는다. 검색 기반으로 만든 주요 상용 리서치 도구도 질의의 17~33%에서 환각을 보였다 [7](Figure 2). 연구자에게 믿을 수 없는 인용은 인용이 없는 것보다 나쁘다.
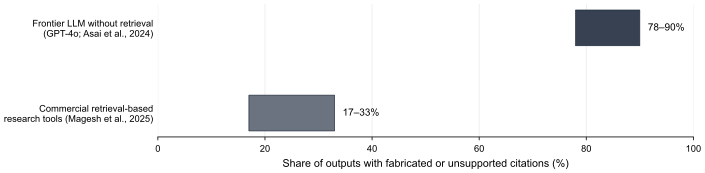
Figure 2. 최근 AI 연구 보조 평가에서 보고된 지어낸 인용 또는 근거 없는 인용의 비율.
1.4 기여
본 논문은 연구자가 인용을 믿고 쓸 수 있도록 만든 시스템 tlooto를 기술한다. 기여는 다음과 같다.
- 해당 질문을 위해 검색하고 선별한 논문만 인용하는 근거 기반 종합(3장).
- 계획, 검색, 선별, 종합, 편집을 하나의 연속된 과정으로 수행하는 에이전트 연구 워크플로(4장).
- 각 계획, 검색, 선별 판단, 중간 결과를 실시간으로 보여 주는 투명한 Work process(4.4절).
- 인용된 근거를 완전한 에디터로 옮기고 저널 선정까지 이어 주는 통합 원고 환경(5장).
2. 관련 연구
2.1 검색 증강 생성과 인용 인식 생성
검색 증강 생성(RAG)은 추론 시점에 가져온 문서에 언어 모델을 조건화하며 [8], 지식 집약적 과업의 지배적 접근법이 되었다 [9]. Gao 등은 모델이 각 진술을 뒷받침하는 구절에 인용을 붙이도록 프롬프트하고 평가할 수 있음을 보였다 [10]. 에이전트 방식은 사고의 사슬 프롬프팅 [12]을 바탕으로 추론과 도구 사용을 번갈아 수행한다 [11].
2.2 과학 문헌을 위한 연구 에이전트
PaperQA는 전문 논문을 검색해 과학 질문에 답하는 에이전트를 제시했고 [13], PaperQA2는 벤치마크에서 전문가 수준을 넘어서는 과학 지식 종합을 보고했다 [14]. OpenScholar는 대규모 오픈 액세스 코퍼스와 검색 증강 모델, 자기 피드백을 결합해 인용을 갖춘 문헌 답변을 생성했다 [15]. AutoSurvey는 서베이 논문 전체의 초안을 쓰며 [16], The AI Scientist [17]와 AI co-scientist [18]는 에이전트를 아이디어 생성, 실험, 가설 검증으로 확장했다.
2.3 근거 종합의 자동화
머신러닝은 오래전부터 체계적 문헌고찰의 선별 단계를 지원해 왔다 [20]. ASReview 같은 능동 학습 도구는 검토자가 읽어야 할 문헌 수를 크게 줄이고 [21], LLM 기반 임상 문헌 선별은 인간 판단과 높은 일치도를 보였다 [22]. PRISMA 2020 같은 보고 기준은 이러한 도구가 가속하는 단계를 정의한다 [23].
2.4 위치 설정
Table 1은 연구자들이 오늘날 가장 흔히 쓰는 도구와 tlooto를 비교한다. tlooto는 에이전트 기반 검색과 선별, 인용에 근거한 종합, 공개된 추론 과정, 완전한 글쓰기 환경을 일상 연구를 위한 하나의 워크스페이스로 결합한다.
Table 1. 연구자들이 흔히 쓰는 도구와의 기능 비교.
| 기능 |
일반 AI 챗봇 |
학술 검색 엔진 |
tlooto |
| 연구 질문에 서술형으로 답변 |
예 |
아니오 |
예 |
| 검색된 논문에 근거한 주장 |
아니오 |
해당 없음 |
예 |
| 검색된 문헌에서 가져온 인용 |
아니오 |
해당 없음 |
예 |
| 명시적 기준에 따른 선별 |
아니오 |
아니오 |
예 |
| 사용자에게 단계별 과정 공개 |
아니오 |
아니오 |
예 (Work process) |
| 인용이 살아 있는 원고 에디터 |
아니오 |
아니오 |
예 |
| 5종 인용 스타일, PDF·DOCX 내보내기 |
아니오 |
내보내기만 |
예 |
| 라이브러리, 프로젝트, 근거 재사용 |
아니오 |
라이브러리만 |
예 |
| 저널 추천 |
아니오 |
아니오 |
예 |
3. 근거 기반 종합
연구 질문을 $q$라 하자. tlooto는 검색식 집합 $Q(q)$를 실행하고 검색 문헌을 모은다.
$$R(q) = \bigcup_{k \in Q(q)} \operatorname{retrieve}(k)$$
선별 단계는 질문에서 도출한 포함 기준 $\phi$를 적용해 근거 집합을 남긴다.
$$E(q) = {, r \in R(q) : \phi(r, q) = 1 ,}$$
리포트 $A$는 진술 $s_1, \dots, s_n$의 연속으로 쓰이며, 각 진술은 인용 집합 $c(s_i)$를 갖는다. tlooto는 다음의 근거화 원칙을 중심으로 설계되었다.
$$\bigcup_{i=1}^{n} c(s_i) ;\subseteq; E(q) ;\subseteq; R(q)$$
따라서 리포트의 참고문헌 목록은 답을 쓴 바로 그 학술 문헌들로 만들어진다. $R(q)$의 모든 문헌은 DOI와 서지 정보를 갖춘 학술 인덱스에서 오므로, tlooto 리포트의 인용은 실제로 존재하고 연구자가 직접 열어 볼 수 있는 논문으로 이어진다.
4. tlooto 워크플로
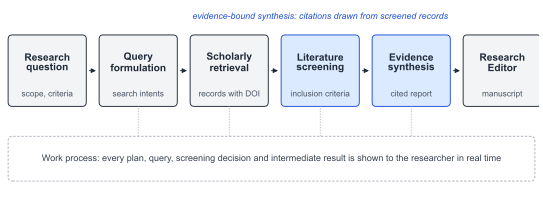
Figure 3. 연구 질문에서 원고까지 tlooto 워크플로. 선별과 종합 단계를 강조했으며, Work process가 모든 단계를 연구자에게 보여 준다.
4.1 계획과 학술 검색
tlooto는 먼저 연구자가 제시한 범위, 학문 분야, 포함 기준과 함께 질문을 해석하고, 이를 상호 보완적인 검색 의도로 나눈다. 단일 검색식 대신 의도마다 재구성한 여러 검색식을 학술 인덱스에 실행하고 결과를 병합한다. 검색된 모든 문헌은 저자, 학술지, 연도, 초록, DOI를 갖춘다.
4.2 문헌 선별
각 후보는 질문에서 도출된 명시적 포함 기준으로 평가되며, 이는 체계적 문헌고찰의 선별 단계와 같다 [20] [21] [22] [23]. 통과한 논문은 순위가 매겨져, 원시 검색 결과가 아닌 집중된 근거 집합으로 종합 단계에 전달된다.
4.3 근거 종합
리포트는 선별된 논문으로 쓰인다. 각 진술에는 번호 인용이 붙고 참고문헌 목록도 같은 문헌에서 만들어지므로, 본문과 참고문헌이 항상 일치한다. 후속 질문은 이미 모은 근거 위에 이어지므로, 탐구가 처음부터 다시 시작되지 않고 깊어진다.
4.4 Work process
모든 계획, 검색, 선별 판단, 중간 결과는 Work process 패널로 연구자에게 실시간 전달된다. 연구자는 무엇을 검색했는지, 어떤 논문을 남겼는지, 답이 어떻게 구성되었는지 확인할 수 있으며, 시스템의 추론 과정을 자신의 연구 방법에 그대로 기록할 수 있다.
4.5 Research Editor
리포트는 한 번의 동작으로 Research Editor에서 열린다. Research Editor는 제목, 표, 그림, 수식, 살아 있는 인용 객체를 지원하는 논문 형식 에디터다. 인용은 문장이 이동하면 자동으로 번호가 다시 매겨지고, APA, MLA, Harvard, Chicago, ISO 690 중 하나로 표시되며, 원고와 함께 PDF나 DOCX로 내보내진다. 연구자는 tlooto에게 절의 수정, 확장, 재구성을 요청할 수 있으며, 그동안 모든 인용은 출처와 연결된 채 유지된다.
Table 2. tlooto 워크플로 단계별로 연구자가 받는 것.
| 단계 |
tlooto가 하는 일 |
연구자가 보는 것 |
| 계획 |
질문, 범위, 기준 해석 |
Work process의 검색 의도 |
| 검색 |
학술 인덱스 다중 검색 |
DOI와 서지 정보를 갖춘 논문 |
| 선별 |
포함 기준 적용과 순위화 |
어떤 논문이 왜 남았는지 |
| 종합 |
남긴 논문으로 구조화된 리포트 작성 |
참고문헌 목록과 일치하는 인용 리포트 |
| 편집 |
리포트를 원고로 발전 |
인용이 살아 있는 논문 형식 초안 |
5. 연구 전 주기 지원
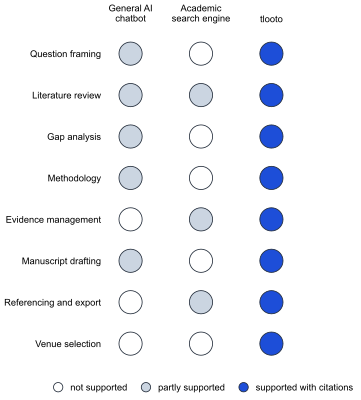
Figure 4. 일반 AI 챗봇, 학술 검색 엔진, tlooto가 지원하는 연구 단계.
tlooto는 단일 목적 도구가 아니라 프로젝트 전체를 위한 하나의 워크스페이스로 설계되었다(Figure 4, Table 3). 질문, 저장한 논문, 업로드한 파일이 프로젝트와 라이브러리에 쌓이므로, 이후의 질문은 새 검색을 시작하는 대신 앞선 근거 위에 쌓인다.
Table 3. tlooto가 지원하는 연구 과업.
| 연구 과업 |
tlooto가 제공하는 것 |
위치 |
| 연구 질문 설정 |
근거 문헌과 함께 제시되는 후보 질문과 이론적 관점 |
Report |
| 문헌 리뷰 |
관점, 합의, 쟁점의 지도와 완전한 인용 |
Report, Paper Search |
| 공백 분석 |
덜 연구된 영역과 이를 규정하는 근거 |
Report |
| 연구 방법 |
해당 방법을 사용한 연구와 연결된 설계, 측정, 분석 |
Report |
| 근거 관리 |
저장한 논문, 업로드한 파일, 재사용 가능한 근거 |
My Library, Projects |
| 원고 작성 |
인용, 표, 그림, 수식을 갖춘 논문 형식 작성 |
Research Editor |
| 참고문헌 |
5종 인용 스타일, 자동 번호 매김, PDF·DOCX 내보내기 |
Research Editor |
| 저널 선정 |
원고 내용에 맞춘 저널 추천 |
AI Journal Finder |
Table 4. 질문 유형별 예시와 tlooto가 생성하는 리포트 구조.
| 질문 유형 |
예시 질문 |
리포트 구조 |
| 연구 질문 |
생성형 AI는 전문 조직의 지식 노동을 어떻게 바꾸고 있는가? |
관점, 후보 질문, 근거 연구 |
| 연구 공백 |
조직의 AI 도입 연구에서 아직 덜 연구된 것은 무엇인가? |
공백, 각 공백의 중요성, 접근 방법 |
| 문헌 리뷰 |
플랫폼 생태계 거버넌스 연구는 지난 5년간 어떻게 발전했는가? |
주제, 합의, 쟁점, 흐름 |
| 근거 |
AI 투자는 기업 성과를 높이는가? |
지지·상충 결과, 조절 변수 |
| 연구 방법 |
심리적 안전감은 AI 도입과 직무 만족을 매개하는가? |
설계, 측정, 표집, 분석 계획 |
6. 논의
tlooto의 핵심 설계 결정은 인용 근거화를 사후 점검이 아니라 답이 만들어지는 방식의 일부로 다룬 것이다. 검색 기반 상용 도구 평가는 검색만으로는 상당한 오류가 남는다는 것을 보여 준다 [7]. tlooto는 명시적 선별을 더하고 각 리포트의 참고문헌을 선별된 논문으로 만들며, 전 과정을 공개해 연구자가 각 결론에 이른 경로를 확인할 수 있게 한다.
두 번째 결정은 통합이다. 연구 에이전트는 기계가 전문가 수준으로 문헌을 종합하고 [14] [15] 뛰어난 연구 아이디어를 만들 수 있음을 보였다 [19]. 그러나 연구자의 일은 답을 얻는 데서 끝나지 않는다. tlooto는 근거를 원고로 곧바로 옮기고, 수정 과정 내내 인용을 살려 두며, 저널 선정까지 지원한다. 검색과 선별에서 절약한 시간이 서식과 참고문헌 정리에서 다시 사라지지 않는다.
이러한 선택은 tlooto를 1장에서 기술한 업무량을 위한 실질적인 연구 파트너로 만든다. 넓게 읽고, 충실하게 인용하며, 학술이 요구하는 형식으로 쓰는 파트너다.
7. 결론
문헌은 이제 어떤 연구자도 읽을 수 없는 속도로 늘어나고, 범용 AI는 아직 참고문헌을 맡기기 어렵다. tlooto는 쓰기 전에 검색하고 선별하며, 모든 참고문헌 목록을 남긴 논문으로 만들고, 작업 과정을 단계별로 보여 주며, 결과를 하나의 워크스페이스 안에서 원고로 발전시키는 에이전트 워크스페이스로 두 문제를 함께 해결한다.