tlooto:用于学术综合和手稿开发的循证代理工作空间
tlooto研究团队
摘要
背景。 学术文献每年增长约 4%,一次系统综述需要专家一年多的努力。大型语言模型(LLM)有望缓解压力,但前沿模型伪造了它们产生的大部分科学引文,甚至基于检索的商业工具在多达三分之一的查询中产生了幻觉。
客观。 我们推出了 tlooto,一个研究工作区,它回答文献中的研究问题,并将答案开发成手稿,其设计使每个引文都指向针对该问题检索的学术记录。
系统。 tlooto 在一个代理工作流程中协调规划、学术检索、文献筛选、证据合成和编辑。每个阶段都会在发生时向研究人员展示,并且综合仅从通过筛选的论文中引用。
能力。 除了问答之外,tlooto 还提供纸质格式编辑器,其中包含五种引文风格的实时引文、表格、图表和方程、直接论文搜索、个人图书馆和项目记忆以及期刊推荐,涵盖从构思到提交的研究生命周期。
意义。 tlooto 使引文可靠性成为答案产生方式的属性,而不是研究人员事后必须验证的东西,并将新兴的研究代理类别引入为日常学术工作设计的形式。
关键词: 研究代理人;检索增强生成;引文接地;证据综合;文献综述自动化;学术写作
1. 引言
1.1 文献规模
一个多世纪以来,科学产出不断增长。博恩曼等人。估计目前的增长率约为每年 4.10%,大约 17 年翻一番 [1]。在临床医学领域,压力更加严峻:2010 年,每天都会发表约 75 项试验和 11 项系统评价 [2] (图1)。手工合成这些证据既缓慢又昂贵;在 PROSPERO 中注册的系统评价从注册到发表平均需要 67.3 周 [3].
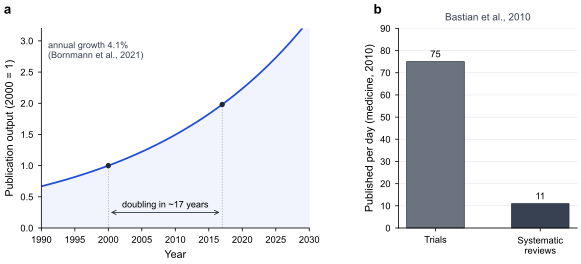
图 1. 科学文献的增长。 (a) 出版物产出按所报告的年增长率 4.1% 计算,翻倍时间约为 17 年。 (b) 2010 年医学领域每日发表的试验和系统评价。
1.2 人工智能进入研究实践
研究人员通过采用人工智能来应对。在《自然》杂志对 1,600 多名科学家进行的一项调查中,大多数人预计人工智能工具对其领域将变得非常重要或必不可少 [4],对已发表记录的分析发现,近期计算机科学论文中多达 17.5% 的 LLM 修改内容 [5]。研究人员紧随其后:他们综合科学知识 [13] [14] [15]、调查文章草稿 [16],产生专家评审员认为比人类想法更新颖的研究想法 [19],并提出并检验假设 [17] [18].
1.3 可靠性差距
然而,通用法学硕士会生成没有来源支持的流畅陈述 [6],而引用是这种失败最明显、成本最高的地方。在 OpenScholar 评估中,GPT-4o 伪造了其产生的 78-90% 的科学引文 [15]。仅靠检索并不能缩小差距:基于检索的领先商业研究工具在 17-33% 的查询中仍然出现幻觉 [7] (图2)。对于研究人员来说,不可信的引用比没有引用更糟糕。
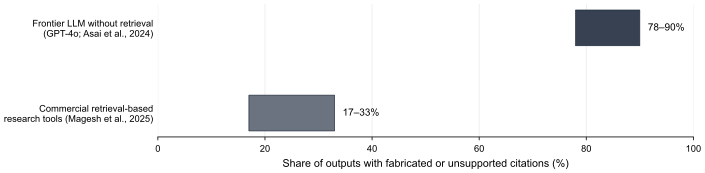
图 2. 最近对人工智能研究援助的评估中所报告的伪造或无依据的引用率。
1.4 贡献
本文介绍了 tlooto,这是一个让研究人员可以依赖其引用的系统。我们的贡献是:
- 循证综合,其中报告仅引用针对当前问题检索和筛选的论文(第 3 节)。
- 代理研究工作流程 在一个连续的过程中进行计划、检索、筛选、综合和编辑(第 4 节)。
- 透明的工作流程 实时向研究人员显示每个计划、查询、筛选决策和中间结果(第 4.4 节)。
- 集成的稿件环境 将引用的证据带入完整的编辑并进行期刊选择(第 5 节)。
2、相关工作
2.1 检索增强和引文感知生成
检索增强生成 (RAG) 以推理时获取的文档为语言模型的条件 [8] 并已成为知识密集型任务的主导方法 [9]。高等人。表明可以提示和评估模型以将引用附加到支持每个陈述的段落 [10]。代理公式将推理与工具的使用交织在一起 [11],建立在思维链提示的基础上 [12].
2.2 科学文献的研究代理人
PaperQA 引入了一个代理,可以检索全文论文来回答科学问题 [13],PaperQA2 报告的科学知识综合超出了其基准专家的表现 [14]。 OpenScholar 将大型开放获取语料库与检索增强模型和自我反馈相结合,以回答带有引文的文献问题 [15]。 AutoSurvey 起草完整的调查文章 [16],而人工智能科学家 [17] 和人工智能联合科学家 [18] 将代理扩展到想法生成、实验和假设检验。
2.3 证据合成自动化
机器学习长期以来一直支持系统评价的筛选阶段 [20]。 ASReview 等主动学习工具大大减少了审阅者必须阅读的记录数量 [21],并且基于LLM的临床审查筛选与人类决策取得了高度一致 [22]。 PRISMA 2020 等报告标准描述了此类工具加速的阶段 [23].
2.4 定位
表 1 将 tlooto 与研究人员当今最常用的工具进行了对比。 tlooto 将代理检索和筛选、基于引文的合成、可见的推理过程和完整的写作环境结合在为日常研究而构建的单个工作区中。
表 1. 与研究人员常用工具的功能比较。
| 能力 |
通用人工智能聊天机器人 |
学术搜索引擎 |
tlooto |
| 用散文回答研究问题 |
是的 |
否 |
是的 |
| 以检索到的论文为基础的主张 |
否 |
不适用 |
是的 |
| 从检索到的记录中提取的引文 |
否 |
不适用 |
是的 |
| 根据明确标准进行筛选 |
否 |
否 |
是的 |
| 用户可见的分步过程 |
否 |
否 |
是(工作流程) |
| 带实时引用的手稿编辑器 |
否 |
否 |
是的 |
| 五种引文样式,PDF 和 DOCX 导出 |
否 |
仅限出口 |
是的 |
| 图书馆、项目和可重复使用的证据 |
否 |
仅图书馆 |
是的 |
| 期刊推荐 |
否 |
否 |
是的 |
3. 循证综合
让 $q$ 表示一个研究问题。 tlooto 发出一组搜索查询 $Q(q)$ 并收集检索到的记录
$$R(q) = \bigcup_{k \in Q(q)} \operatorname{retrieve}(k)$$
筛选适用纳入标准 $\phi$ 从问题中得出并保留证据集
$$E(q) = {, r \in R(q) : \phi(r, q) = 1 ,}$$
报告 $A$ 被写成语句序列 $s_1, \dots, s_n$,每个都带有一个引文集 $c(s_i)$。 tlooto 是围绕接地原理设计的
$$\bigcup_{i=1}^{n} c(s_i) ;\subseteq; E(q) ;\subseteq; R(q)$$
因此,报告的参考文献列表是根据撰写答案的相同学术记录构建的。因为每一条记录 $R(q)$ 来自具有 DOI 和书目元数据的学术索引,tlooto 报告中的引用会导致存在且研究人员可以打开的论文。
4. tlooto 工作流程
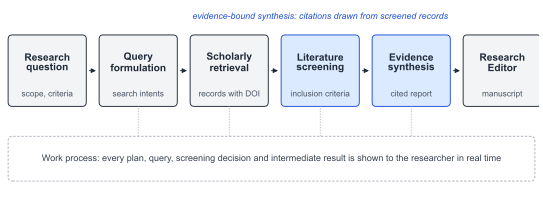
图 3. 从研究问题到手稿的 tlooto 工作流程。强调筛选和合成;工作流程使研究人员可以看到每个阶段。
4.1 规划与学术检索
tlooto 首先将问题与研究人员提供的任何范围、学科和纳入标准一起解释,并将其分解为互补的搜索意图。它不是发出单个查询,而是针对学术索引针对每个意图运行多个重新构造的查询并合并结果。每条检索到的记录都带有其作者、地点、年份、摘要和 DOI。
4.2 文献筛选
每个候选人都会根据问题中明确的纳入标准进行评估,反映系统审查的筛选阶段 [20] [21] [22] [23]。通过的论文将被排名并作为重点证据集而不是原始搜索结果列表进行综合。
4.3 证据综合
该报告是根据筛选的论文撰写的。每个陈述都带有编号的引文,并且参考列表是根据相同的记录生成的,因此正文和参考书目始终一致。后续问题建立在已经收集的证据的基础上,因此一系列调查会加深而不是重新开始。
4.4 工作流程
每个计划、查询、筛选决策和中间结果都会在工作流程面板中传输给研究人员。研究人员可以看到搜索的内容、保留了哪些论文以及如何组合答案,从而将系统的推理转化为他们可以跟踪并用自己的方法引用的记录。
4.5 研究编辑
只需执行一个操作,即可在研究编辑器中打开报告,这是一种支持标题、表格、图表、方程式和实时引文对象的纸质格式编辑器。引文会随着文本移动而自动重新编号,以 APA、MLA、Harvard、Chicago 或 ISO 690 格式呈现,并与稿件一起导出为 PDF 或 DOCX。研究人员可以要求 tlooto 修改、扩展或重组部分内容,同时每个引文都附有其来源。
表 2. tlooto 工作流程的各个阶段以及研究人员在每个阶段收到的内容。
| 舞台 |
tlooto 做什么 |
研究人员看到了什么 |
| 规划 |
解释问题、范围和标准 |
在工作流程中搜索意图 |
| 检索 |
对学术索引运行多个查询 |
检索带有 DOI 和元数据的论文 |
| 筛选 |
应用纳入标准并对论文进行排名 |
哪些文件被保留以及为什么 |
| 综合 |
根据保存的论文撰写结构化报告 |
被引用的报告以及匹配的参考文献列表 |
| 编辑 |
将报告发展成手稿 |
带有实时引用的纸质草稿 |
5. 研究生命周期的覆盖范围
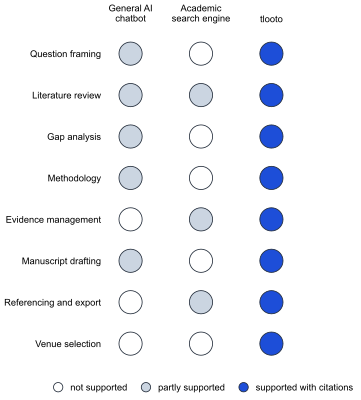
图 4. 由通用人工智能聊天机器人、学术搜索引擎和 tlooto 支持的研究阶段。
tlooto 被设计为整个项目的一个工作区,而不是单一用途的工具(图 4、表 3)。问题、保存的论文和上传的文件会在项目和库中累积,因此后面的问题会建立在早期证据的基础上,而不是开始新的搜索。
表 3. tlooto 支持的研究任务。
| 研究任务 |
tlooto 提供什么 |
哪里 |
| 提出一个研究问题 |
候选人问题和理论观点以及支持文献 |
报告 |
| 研究评论 |
观点、共识和辩论图,充分引用 |
报告、论文检索 |
| 差距分析 |
未充分探索的领域及其定义证据 |
报告 |
| 方法学 |
与使用它们的研究相关的设计、测量和分析 |
报告 |
| 证据管理 |
保存的论文、上传的文件和可重复使用的证据 |
我的图书馆,项目 |
| 稿件起草 |
带有实时引文、表格、图形和方程的纸质起草 |
研究编辑 |
| 参考文献 |
五种引文样式、自动重新编号、PDF 和 DOCX 导出 |
研究编辑 |
| 场地选择 |
与稿件相匹配的期刊推荐 |
AI Journal Finder |
表 4. 示例问题和 tlooto 生成的报告结构。
| 问题类型 |
示例问题 |
报告结构 |
| 研究问题 |
生成式人工智能如何改变专业组织中的知识工作? |
观点、候选人问题、支持研究 |
| 研究差距 |
在组织中采用人工智能的研究中,哪些内容尚未得到充分探索? |
差距、为何各自重要、如何解决 |
| 研究评论 |
五年来平台生态系统治理研究如何演变? |
主题、协议、辩论、轨迹 |
| 证据 |
人工智能投资会提高公司绩效吗? |
支持和相互矛盾的调查结果,主持人 |
| 方法学 |
心理安全感是否会影响人工智能的采用和工作满意度? |
设计、测量、取样、分析计划 |
6. 讨论
tlooto 的核心设计决策是将引用接地视为生成答案的一部分,而不是事后应用的检查。对基于检索的商业工具的评估表明,检索本身仍然会留下重大错误 [7]; tlooto 增加了明确的筛选,并从筛选的论文中构建每份报告的参考文献,它公开了整个过程,以便研究人员可以看到每个结论是如何得出的。
第二个决定是整合。研究人员表明,机器可以合成专家级别的文献 [14] [15] 并产生强有力的研究想法 [19],然而研究人员的工作并没有以答案结束。 tlooto 将证据直接带入手稿,通过修订保持引用实时并支持期刊选择,因此在搜索和筛选中节省的时间不会在格式设置和参考文献中再次浪费。
这些选择共同使 tlooto 成为第 1 节中描述的工作量的实用研究合作伙伴:广泛阅读、忠实引用并按照学术要求的形式写作。
7. 结论
现在文献的增长速度超过了任何研究人员的阅读速度,而通用人工智能还不能被信任作为参考。 tlooto 通过代理工作区解决了这两个问题,该工作区在写作之前进行检索和筛选,根据其保存的论文构建每个参考列表,逐步显示其工作,并将结果在单个工作区中开发为手稿。