

पंक्तियाँ चार्ट बनती हैं, चार्ट कैप्शन वाला फ़िगर बनता है। उदाहरण के तौर पर।
डेटा एक स्प्रेडशीट में है। जो विश्लेषण चाहिए वह जटिल नहीं है: समूहों की तुलना, एक ट्रेंड, एक correlation। लेकिन आपके और फ़िगर के बीच खड़े हैं एक अनजाना स्टैटिस्टिक्स पैकेज, एक प्लॉटिंग लाइब्रेरी, और axis लेबल से एक घंटे की जूझ।
डेटा से सवाल पूछें
tlooto में फ़ाइल अटैच करें और सरल भाषा में बताएँ कि आपको क्या चाहिए। स्प्रेडशीट और डेटा फ़ाइलें समर्थित हैं, जिनमें .xlsx, .xls, .csv, .json और .xml शामिल हैं, हर फ़ाइल 20 MB तक और एक बार में 10 फ़ाइलें तक।
- रोज़ सात घंटे से ज़्यादा और कम फ़ोन इस्तेमाल करने वाले छात्रों के बीच औसत GPA की तुलना करो, और अंतर को 95% confidence interval के साथ बताओ।
- रात की नींद के घंटों के मुकाबले GPA को ट्रेंड लाइन के साथ प्लॉट करो।
- किन वेरिएबल में मान गायब हैं, और कितने?
विश्लेषण संख्याओं और इस व्याख्या के साथ लौटता है कि क्या किया गया, ताकि आप उसे जाँच सकें और अपने methods में उसका वर्णन कर सकें।
चार्ट से फ़िगर तक
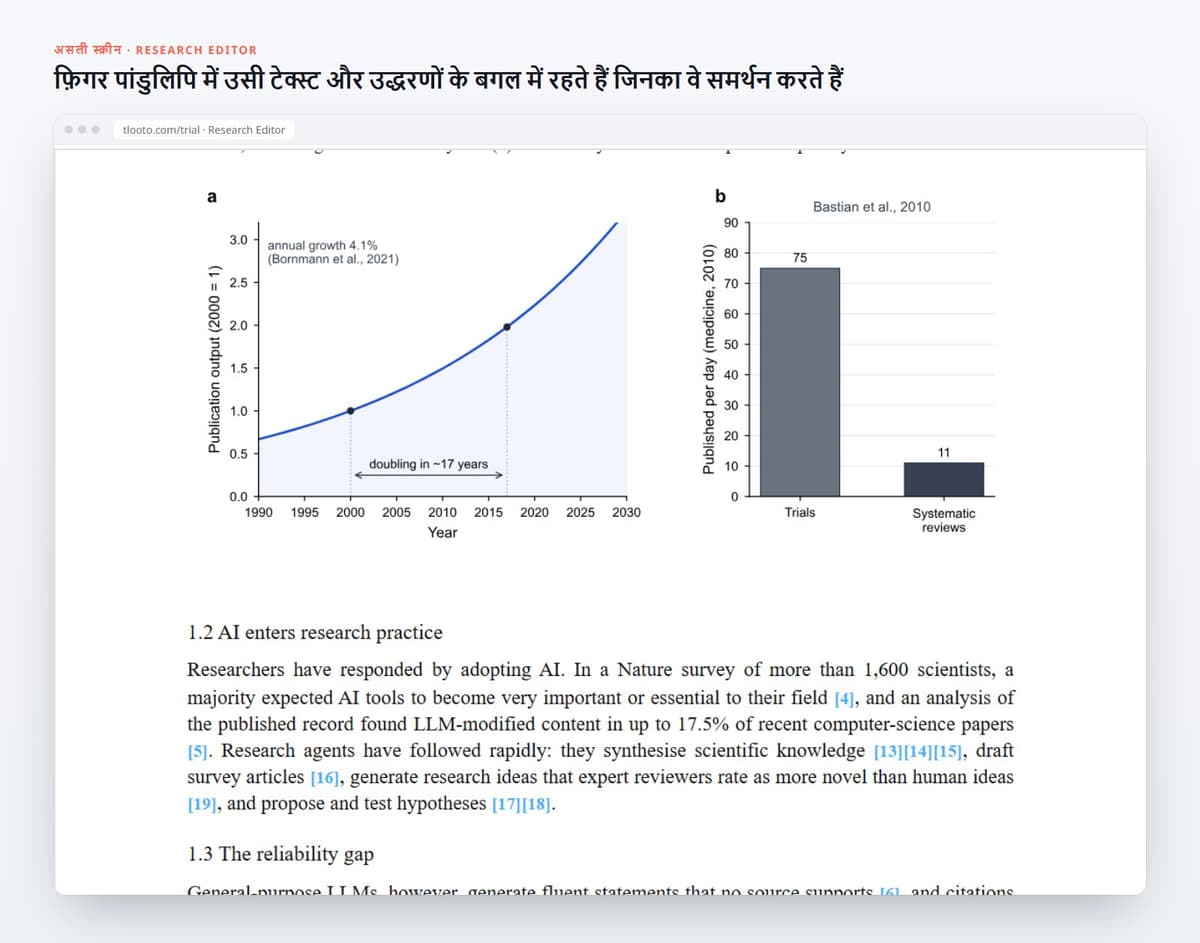
पेपर के फ़िगर को चार्ट से ज़्यादा चाहिए: एक जैसे फ़ॉन्ट, इकाइयों के साथ लेबल किए axis, ऐसा legend जो डेटा को न ढके, और ऐसा कैप्शन जो बताए कि पाठक को क्या देखना चाहिए। ये बदलाव सीधे माँगें, फिर फ़िगर को Research Editor में उसी टेक्स्ट और उद्धरणों के बगल में रखें जिनका वह समर्थन करता है।
भरोसा करने से पहले जाँचें
- पहले डेटा देखें। कोई भी टेस्ट करने से पहले हर कॉलम का सारांश और गायब मान माँगें।
- टेस्ट की पुष्टि करें। पक्का करें कि method आपके design से मेल खाता है, और पूछें कि उसे क्यों चुना गया।
- मुख्य संख्या खुद दोबारा निकालें। जो नतीजा आपके पेपर की नींव है, उसे एक बार अपनी पसंद के टूल में सत्यापित करें।
इस तरह इस्तेमाल करने पर tlooto स्प्रेडशीट और सबमिशन-लायक फ़िगर के बीच की मशीनी अड़चनें हटा देता है, जबकि विश्लेषण से जुड़े फ़ैसले आपके हाथ में रहते हैं।