tlooto: un espacio de trabajo agente basado en evidencia para la síntesis académica y el desarrollo de manuscritos
equipo de investigación tlooto
Resumen
Antecedentes. La literatura académica crece aproximadamente un 4% al año y una sola revisión sistemática requiere más de un año de esfuerzo de expertos. Los modelos de lenguajes grandes (LLM) prometen alivio, pero los modelos de frontera fabrican la mayoría de las citas científicas que producen, e incluso las herramientas comerciales basadas en la recuperación alucinan en hasta un tercio de las consultas.
Objetivo. Presentamos tlooto, un espacio de trabajo de investigación que responde preguntas de investigación de la literatura y desarrolla la respuesta en un manuscrito, diseñado para que cada cita apunte a un registro académico recuperado para la pregunta.
Sistema. tlooto coordina la planificación, la recuperación académica, la selección de literatura, la síntesis de evidencia y la edición en un único flujo de trabajo agente. Cada etapa se muestra al investigador a medida que ocurre, y la síntesis extrae sus citas sólo de artículos que pasaron la selección.
Capacidades. Más allá de responder preguntas, tlooto proporciona un editor en formato de papel con citas en vivo, tablas, figuras y ecuaciones en cinco estilos de citas, búsqueda directa de artículos, una biblioteca personal y memoria de proyectos, y recomendaciones de revistas, que cubren el ciclo de vida de la investigación desde la idea hasta el envío.
Importancia. tlooto hace que la confiabilidad de las citas sea una propiedad de cómo se produce la respuesta, en lugar de algo que el investigador deba verificar después, y reúne a la clase emergente de agentes de investigación en una forma diseñada para el trabajo académico cotidiano.
Palabras clave: agentes de investigación; generación de recuperación aumentada; fundamentación de citaciones; síntesis de evidencia; automatización de revisión de literatura; escritura académica
1. Introducción
1.1 La escala de la literatura
La producción científica ha crecido continuamente durante más de un siglo. Bornmann et al. Estimamos el crecimiento actual en alrededor del 4,10% anual, un tiempo de duplicación de aproximadamente 17 años. [1]. En la medicina clínica la presión es aún mayor: ya en 2010 se publicaban cada día unos 75 ensayos y 11 revisiones sistemáticas. [2] (Figura 1). Sintetizar esta evidencia a mano es lento y costoso; las revisiones sistemáticas registradas en PROSPERO tardaron una media de 67,3 semanas desde el registro hasta la publicación [3].
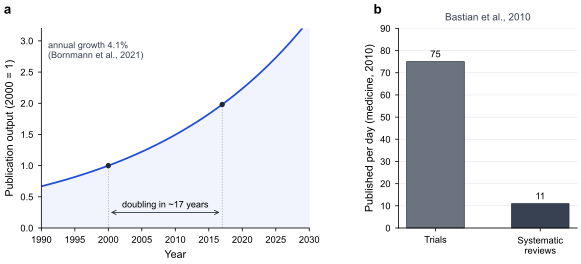
Figura 1. Crecimiento de la literatura científica. (a) La producción de publicaciones se modeló según la tasa de crecimiento anual reportada del 4,1%, un tiempo de duplicación de aproximadamente 17 años. (b) Ensayos y revisiones sistemáticas publicados por día en medicina en 2010.
1.2 La IA entra en la práctica de la investigación
Los investigadores han respondido adoptando IA. En una encuesta de Nature realizada a más de 1.600 científicos, la mayoría esperaba que las herramientas de IA se volvieran muy importantes o esenciales para su campo. [4], y un análisis del registro publicado encontró contenido modificado por LLM en hasta el 17,5% de los artículos recientes de informática. [5]. Los agentes de investigación han seguido rápidamente: sintetizan el conocimiento científico. [13] [14] [15], borradores de artículos de encuesta. [16], generar ideas de investigación que los revisores expertos califican como más novedosas que las ideas humanas [19]y proponer y probar hipótesis [17] [18].
1.3 La brecha de confiabilidad
Los LLM de propósito general, sin embargo, generan declaraciones fluidas que ninguna fuente respalda [6], y las citas son donde este fracaso es más visible y más costoso. En la evaluación de OpenScholar, GPT-4o fabricó entre el 78% y el 90% de las citas científicas que produjo. [15]. La recuperación por sí sola no cierra la brecha: las principales herramientas de investigación comerciales basadas en la recuperación todavía causan alucinaciones en entre el 17% y el 33% de las consultas. [7] (Figura 2). Para los investigadores, una cita en la que no se puede confiar es peor que ninguna cita.
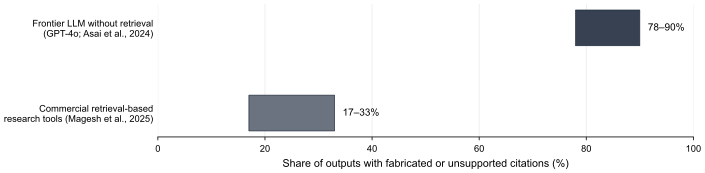
Figura 2. Tasas reportadas de citas inventadas o no respaldadas en evaluaciones recientes de asistencia a la investigación de IA.
1.4 Contribuciones
Este artículo describe tlooto, un sistema creado para que los investigadores puedan confiar en sus citas. Nuestros aportes son:
- Síntesis basada en evidencia, en el que un informe cita sólo artículos recuperados y examinados para la pregunta en cuestión (Sección 3).
- Un flujo de trabajo de investigación agente que planifica, recupera, filtra, sintetiza y edita en un proceso continuo (Sección 4).
- Un proceso de trabajo transparente que muestra al investigador cada plan, consulta, decisión de selección y resultado intermedio en tiempo real (Sección 4.4).
- Un entorno de manuscrito integrado que lleva la evidencia citada a un editor completo y luego a la selección de la revista (Sección 5).
2. Trabajo relacionado
2.1 Generación con reconocimiento de citas y recuperación aumentada
La generación de recuperación aumentada (RAG) condiciona un modelo de lenguaje en documentos obtenidos en el momento de la inferencia [8] y se ha convertido en el enfoque dominante para tareas intensivas en conocimiento [9]. Gao et al. demostró que se puede incitar y evaluar a los modelos para que adjunten citas a los pasajes que respaldan cada afirmación [10]. Las formulaciones agentes intercalan el razonamiento con el uso de herramientas. [11], basándose en indicaciones de cadena de pensamiento [12].
2.2 Agentes de investigación de la literatura científica
PaperQA presentó un agente que recupera artículos de texto completo para responder preguntas científicas [13]y PaperQA2 informó una síntesis de conocimiento científico que superó el desempeño de los expertos en sus puntos de referencia. [14]. OpenScholar combinó un gran corpus de acceso abierto con un modelo de recuperación aumentada y auto-retroalimentación para responder preguntas sobre literatura con citas. [15]. AutoSurvey redacta artículos de encuestas completos [16], mientras que The AI Scientist [17] y cocientífico de IA [18] extender los agentes a la generación de ideas, la experimentación y la prueba de hipótesis.
2.3 Automatización de la síntesis de evidencia.
El aprendizaje automático ha apoyado durante mucho tiempo la etapa de selección de revisiones sistemáticas. [20]. Las herramientas de aprendizaje activo como ASReview reducen sustancialmente la cantidad de registros que los revisores deben leer [21], y la selección de revisiones clínicas basada en LLM ha logrado un alto acuerdo con las decisiones humanas [22]. Los estándares de informes como PRISMA 2020 describen las etapas que aceleran dichas herramientas [23].
2.4 Posicionamiento
La Tabla 1 contrasta tlooto con las herramientas que los investigadores utilizan con mayor frecuencia en la actualidad. tlooto combina recuperación y selección de agentes, síntesis basada en citas, un proceso de razonamiento visible y un entorno de escritura completo en un único espacio de trabajo creado para la investigación diaria.
Tabla 1. Comparación de capacidades con herramientas que los investigadores utilizan habitualmente.
| Capacidad |
Chatbot general de IA |
Buscador académico |
tlooto |
| Responde una pregunta de investigación en prosa. |
si |
No |
si |
| Reclamaciones basadas en documentos recuperados |
No |
No aplicable |
si |
| Citas extraídas de registros recuperados |
No |
No aplicable |
si |
| Cribado según criterios explícitos |
No |
No |
si |
| Proceso paso a paso visible para el usuario |
No |
No |
Sí (proceso de trabajo) |
| Editor de manuscritos con citas en vivo. |
No |
No |
si |
| Cinco estilos de citas, exportación a PDF y DOCX |
No |
Exportar solo |
si |
| Biblioteca, proyectos y evidencia reutilizable |
No |
Sólo biblioteca |
si |
| Recomendación de revista |
No |
No |
si |
3. Síntesis basada en evidencia
dejar $q$ denota una pregunta de investigación. tlooto emite un conjunto de consultas de búsqueda $Q(q)$ y recopila los registros recuperados
$$R(q) = \bigcup_{k \in Q(q)} \operatorname{retrieve}(k)$$
El cribado aplica criterios de inclusión. $\phi$ derivada de la pregunta y mantiene la evidencia establecida
$$E(q) = {, r \in R(q) : \phi(r, q) = 1 ,}$$
el informe $A$ se escribe como una secuencia de declaraciones $s_1, \dots, s_n$, cada uno con un conjunto de citas $c(s_i)$. tlooto está diseñado según el principio de fundamentación en fuentes
$$\bigcup_{i=1}^{n} c(s_i) ;\subseteq; E(q) ;\subseteq; R(q)$$
de modo que la lista de referencias de un informe se construya a partir de los mismos registros académicos desde los que se escribió la respuesta. Porque cada registro en $R(q)$ proviene de un índice académico con su DOI y metadatos bibliográficos, las citas en un informe tlooto conducen a artículos que existen y que el investigador puede abrir.
4. El flujo de trabajo de tlooto
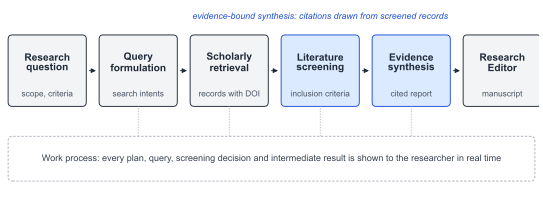
Figura 3. El flujo de trabajo de tlooto desde la pregunta de investigación hasta el manuscrito. Se destacan la selección y la síntesis; El proceso de trabajo hace que cada etapa sea visible para el investigador.
4.1 Planificación y recuperación académica
tlooto primero interpreta la pregunta junto con cualquier alcance, disciplina y criterio de inclusión que proporcione el investigador, y la divide en intenciones de búsqueda complementarias. En lugar de emitir una única consulta, ejecuta varias consultas reformuladas por intención en un índice académico y combina los resultados. Cada registro recuperado lleva sus autores, lugar, año, resumen y DOI.
4.2 Selección de literatura
Cada candidato es evaluado según criterios de inclusión explícitos extraídos de la pregunta, reflejando la etapa de selección de una revisión sistemática. [20] [21] [22] [23]. Los artículos que aprueban se clasifican y se pasan a síntesis como un conjunto de evidencia enfocada en lugar de una lista sin procesar de resultados de búsqueda.
4.3 Síntesis de evidencia
El informe se redacta a partir de los artículos seleccionados. Cada enunciado lleva una cita numerada y la lista de referencias se genera a partir de los mismos registros, por lo que el cuerpo y la bibliografía siempre coinciden. Las preguntas de seguimiento se basan en la evidencia ya reunida, por lo que una línea de investigación se profundiza en lugar de reiniciarse.
4.4 El proceso de trabajo
Cada plan, consulta, decisión de selección y resultado intermedio se transmite al investigador en el panel de proceso de trabajo. Los investigadores pueden ver qué se buscó, qué documentos se guardaron y cómo se reunió la respuesta, convirtiendo el razonamiento del sistema en un registro que pueden seguir y citar con sus propios métodos.
4.5 Editor de investigación
Con una acción, el informe se abre en el Editor de investigación, un editor en formato papel que admite encabezados, tablas, figuras, ecuaciones y objetos de citas en vivo. Las citas se renumeran automáticamente a medida que se mueve el texto, se procesan en APA, MLA, Harvard, Chicago o ISO 690 y se exportan con el manuscrito a PDF o DOCX. Los investigadores pueden pedirle a tlooto que revise, amplíe o reestructure secciones mientras cada cita permanece adjunta a su fuente.
Tabla 2. Etapas del flujo de trabajo de tlooto y lo que recibe el investigador en cada una.
| etapa |
¿Qué hace tlooto? |
Lo que ve el investigador |
| Planificación |
Interpreta la pregunta, alcance y criterios. |
Intenciones de búsqueda en el proceso de Trabajo |
| Recuperación |
Ejecuta múltiples consultas en un índice académico |
Artículos recuperados con DOI y metadatos. |
| Proyección |
Aplica criterios de inclusión y clasifica los artículos. |
¿Qué documentos se conservaron y por qué? |
| Síntesis |
Escribe un informe estructurado a partir de los documentos guardados. |
Informe citado con una lista de referencias coincidentes. |
| Edición |
Desarrolla el informe en un manuscrito. |
Borrador en formato papel con citas en vivo. |
5. Cobertura del ciclo de vida de la investigación
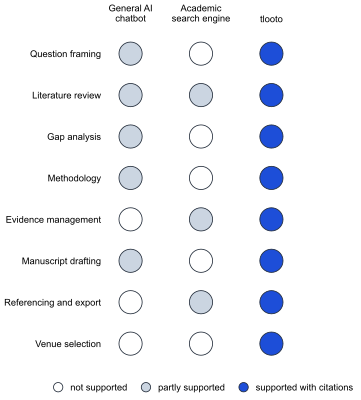
Figura 4. Etapas de investigación respaldadas por un chatbot general de IA, un motor de búsqueda académico y tlooto.
tlooto está diseñado como un espacio de trabajo para todo el proyecto en lugar de una herramienta de propósito único (Figura 4, Tabla 3). Las preguntas, los artículos guardados y los archivos cargados se acumulan en los proyectos y en la biblioteca, por lo que las preguntas posteriores se basan en evidencia anterior en lugar de iniciar una nueva búsqueda.
Tabla 3. Tareas de investigación apoyadas por tlooto.
| Tarea de investigación |
Lo que ofrece tlooto |
donde |
| Formular una pregunta de investigación |
Preguntas de los candidatos y perspectivas teóricas con literatura de apoyo. |
Informe |
| Revisión de investigación |
Mapa de perspectivas, consensos y debates, íntegramente citado |
Informe, búsqueda en papel |
| Análisis de brechas |
Áreas poco exploradas con la evidencia que las define |
Informe |
| Metodología |
Diseños, medidas y análisis vinculados a estudios que los utilizaron. |
Informe |
| Gestión de pruebas |
Documentos guardados, archivos cargados y evidencia reutilizable |
Mi Biblioteca, Proyectos |
| Redacción de manuscritos |
Redacción en formato papel con citas en vivo, tablas, figuras y ecuaciones. |
Editor de investigación |
| Referenciando |
Cinco estilos de citas, renumeración automática, exportación a PDF y DOCX |
Editor de investigación |
| Selección del lugar |
Recomendaciones de revistas coincidentes con el manuscrito. |
AI Journal Finder |
Tabla 4. Preguntas de ejemplo y la estructura del informe que produce tlooto.
| Tipo de pregunta |
Pregunta de ejemplo |
Estructura del informe |
| Pregunta de investigación |
¿Cómo está cambiando la IA generativa el trabajo del conocimiento en las organizaciones profesionales? |
Perspectivas, preguntas de los candidatos, estudios de apoyo. |
| Brecha de investigación |
¿Qué queda sin explorar en la investigación sobre la adopción de la IA en las organizaciones? |
Brechas, por qué cada una es importante, cómo abordarla |
| Revisión de investigación |
¿Cómo ha evolucionado la investigación sobre la gobernanza del ecosistema de plataformas a lo largo de cinco años? |
Temas, acuerdos, debates, trayectoria |
| Evidencia |
¿La inversión en IA mejora el rendimiento de la empresa? |
Hallazgos favorables y contradictorios, moderadores |
| Metodología |
¿La seguridad psicológica influye en la adopción de la IA y la satisfacción laboral? |
Diseño, medidas, muestreo, plan de análisis. |
6. Discusión
La decisión de diseño central en tlooto es tratar la base de las citas como parte de cómo se produce una respuesta en lugar de como una verificación aplicada posteriormente. Las evaluaciones de herramientas comerciales basadas en la recuperación muestran que la recuperación por sí sola todavía deja errores sustanciales. [7]; tlooto agrega una selección explícita y construye las referencias de cada informe a partir de los artículos seleccionados, y expone todo el proceso para que los investigadores puedan ver cómo se llegó a cada conclusión.
La segunda decisión es la integración. Agentes de investigación han demostrado que las máquinas pueden sintetizar literatura a nivel experto [14] [15] y generar ideas de investigación sólidas [19]Sin embargo, el trabajo de un investigador no termina con una respuesta. tlooto lleva la evidencia directamente al manuscrito, mantiene las citas activas durante la revisión y respalda la selección de revistas, para que el tiempo ahorrado en la búsqueda y la selección no se pierda nuevamente en el formato y las referencias.
En conjunto, estas opciones hacen de tlooto un compañero de investigación práctico para la carga de trabajo descrita en la Sección 1: uno que lee mucho, cita fielmente y escribe en la forma que requiere el conocimiento académico.
7. Conclusión
La literatura ahora crece más rápido de lo que cualquier investigador puede leer, y todavía no se pueden confiar referencias a la IA de propósito general. tlooto aborda ambos problemas con un espacio de trabajo agente que recupera y analiza antes de escribir, crea cada lista de referencias a partir de los artículos que conserva, muestra su trabajo paso a paso y desarrolla el resultado en un manuscrito dentro de un único espacio de trabajo.