

情况通常是这样的:稿子两天后就要交,聊天机器人给了你一段整整齐齐、附带四条参考文献的文字,第三条看起来无可挑剔。作者名像真的,期刊领域也对,发表年份是 2021 年。四十分钟搜下来,你终于接受现实:这篇论文从来没有人写过。
这并不是偶发故障。有研究者让 ChatGPT 就 42 个主题撰写简短的文献综述,结果 GPT-3.5 给出的引文中有 55%、GPT-4 给出的引文中有 18% 是虚构的,而且许多真实引文也存在实质性错误 [1]。在 OpenScholar 的评测中,GPT-4o 生成的科学引文有 78% 到 90% 是编造的 [2]。
代价也不只是尴尬。学位论文章节或投稿稿件里出现虚构文献,属于科研诚信问题,而审稿人和导师核查得越来越仔细。
聊天机器人为什么会编造参考文献
通用聊天机器人是凭模型“记忆”来写作的。它知道你所在领域的引文通常长什么样:常见哪些姓氏、哪些期刊、哪些年份。即便想不起真实的文献,它依然能拼出一条格式完全正确的引文。读起来毫无破绽,这恰恰是它能蒙混过关的原因。
五分钟参考文献核查
任何借助 AI 生成的参考文献,在放进稿件之前都先做以下检查。每段只需几分钟,几乎能拦下所有问题。
- 解析 DOI。 把它粘贴到 https://doi.org/ 后面。如果没有 DOI,或者跳转到的是另一篇论文,就此打住。
- 核对三个字段。 第一作者、年份和期刊必须与落地页完全一致。虚构文献往往只对得上其中两项。
- 对照摘要看论点。 真实存在的论文也可能被拿来支撑它从未说过的观点。确认摘要确实支持引用它的那句话。
- 加引号搜索标题。 真实论文能在学术索引中查到;虚构的要么搜不到,要么只搜到一篇作者列表不同的相似论文。
- 保存 PDF 或落地页。 打不开的文献,你在答辩或同行评审时就无法为它辩护。
更好的做法:没检索到的论文,一律不进稿件
事后核查有用,但很慢。更可靠的办法是调整顺序:先检索,再筛选结果,最后才动笔,而且只引用真正检索到的论文。
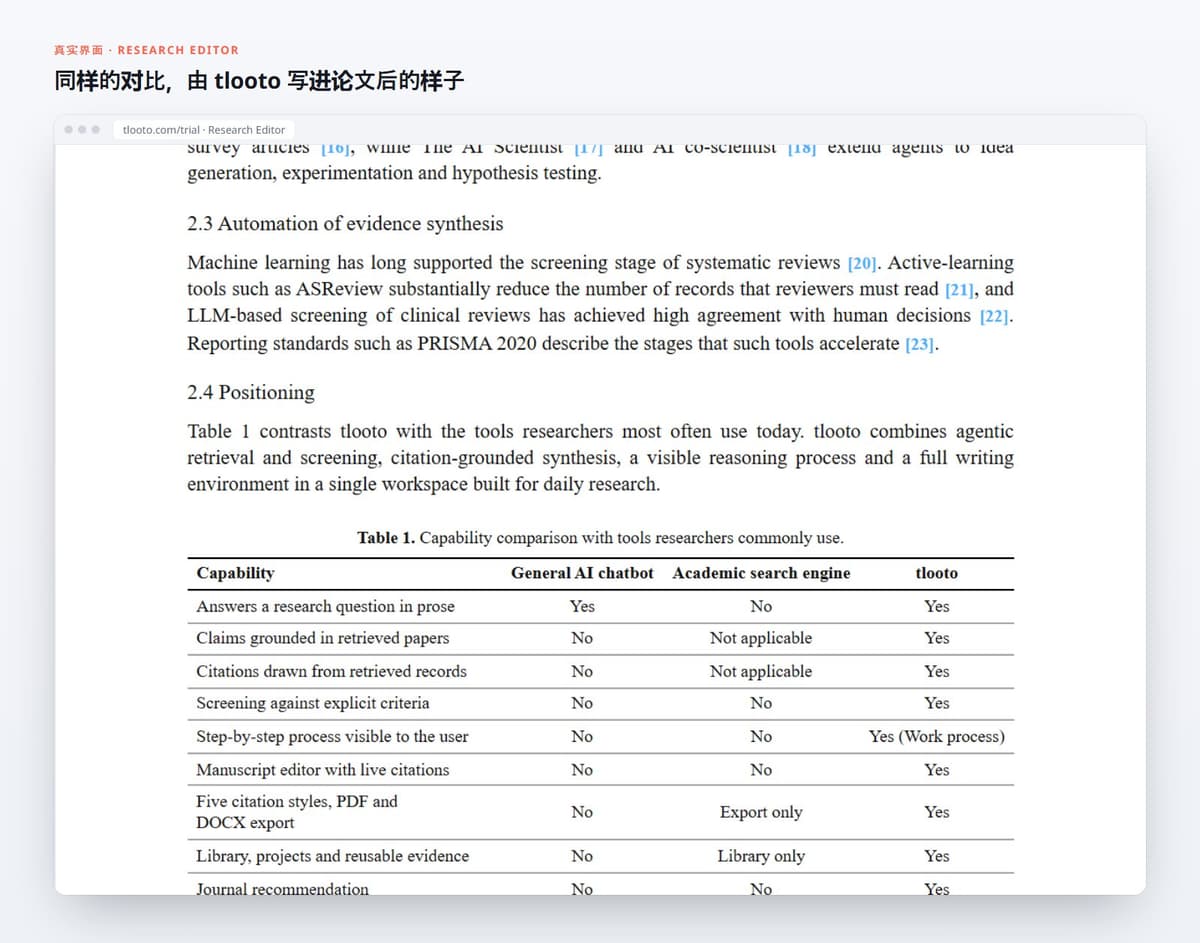
tlooto 正是按这个逻辑设计的。你提出研究问题后,tlooto 会规划一组检索,从学术索引中获取带有作者、出处、年份、DOI 和摘要的论文,按你的标准进行筛选,再基于通过筛选的论文撰写报告。每句话都带有编号引文,参考文献列表与正文出自同一批记录,因此两者始终一致。
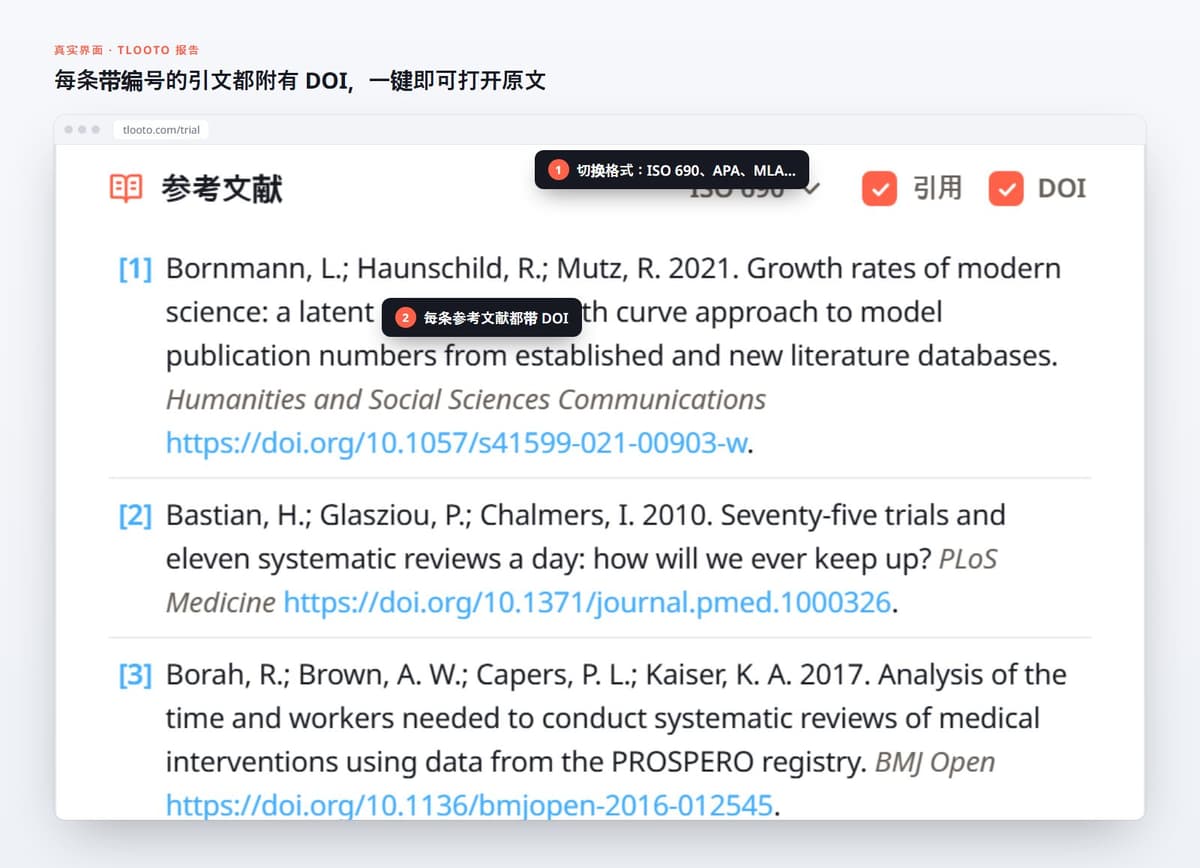
tlooto 报告中的参考文献列表。每条都链接到对应的 DOI,切换引文格式也无需改写任何内容。
论文还是要你自己读。tlooto 不会替你做研究判断,也不应该这样做。但你的起点是一份真实存在的文献清单,而不是一段需要逐条拆解的文字。
给课题组或班级的一条简单规则
打不开的参考文献,一律不用。把这条规则分享给所有用 AI 辅助写作的人。它简单到凌晨两点也记得住,而这类错误大多正是在那个时间犯下的。
参考文献
[1] Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13. https://doi.org/10.1038/s41598-023-41032-5
[2] Asai, A., et al. (2024). OpenScholar: Synthesizing scientific literature with retrieval-augmented LMs. arXiv. https://arxiv.org/abs/2411.14199