

我们在 tlooto 的论文搜索中输入了一个普通查询:large language models title abstract screening systematic review。返回的结果数是 24,053,355 篇论文。第一页相关,第五页也相关。陷阱就在这里。
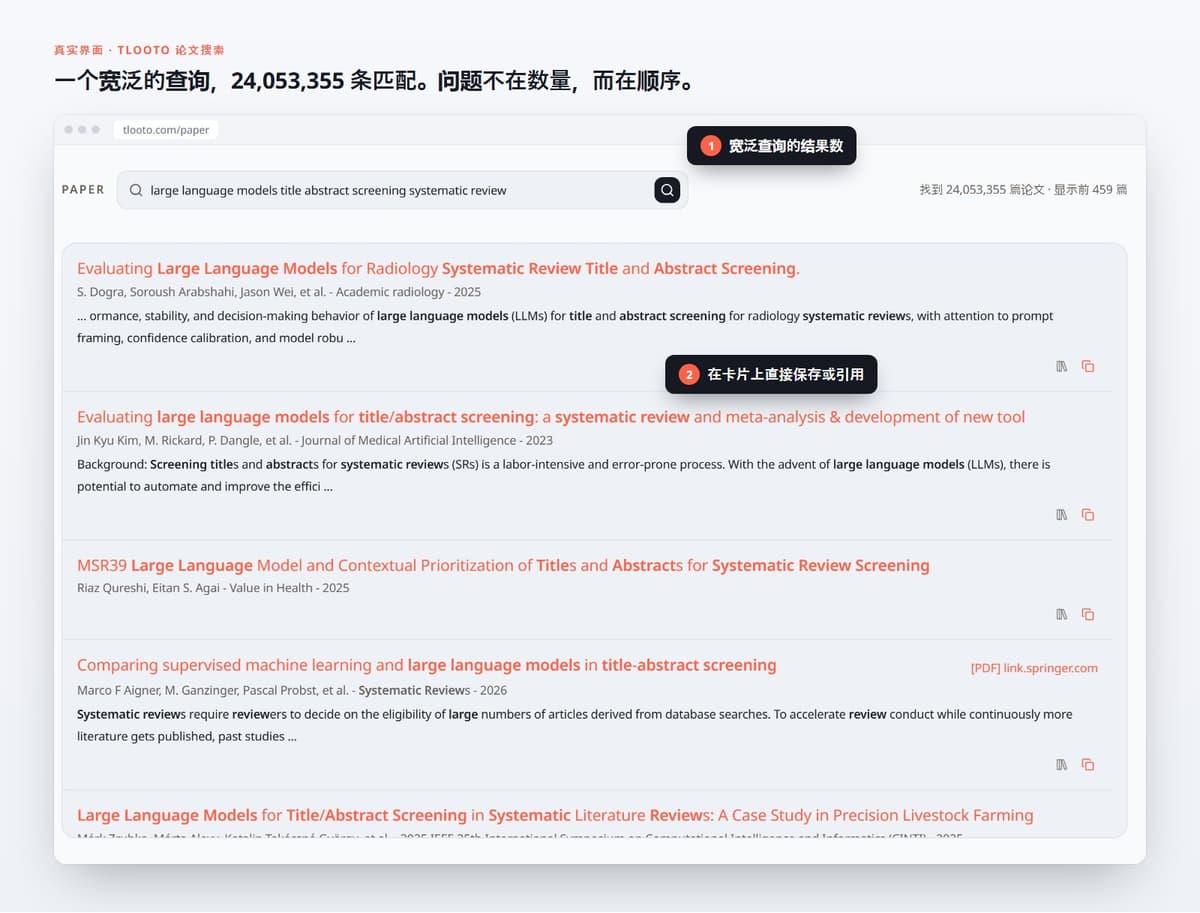
当所有结果看起来都相关时,人们通常会做两件事之一:读完前十条就停下,或者开四十个标签页然后耗掉一下午。两种做法都得不到一份能向导师解释清楚的阅读清单。科研产出每年增长约 4.1%,大约每 17 年翻一番 [1],这个问题不会自己变简单。
下面是我们推荐的流程,全程大约三十分钟。
第 0–5 分钟:把问题写成一句话
不是一个话题,而是一个包含研究对象、暴露因素或方法、以及结局的问题。大学生夜间使用手机与 GPA 有何关系?睡眠能否解释其中一部分? 这样的问题可以检索;手机与学生 则不行。
第 5–12 分钟:拆成三到四个检索意图
每个意图覆盖问题的一个角度:核心关系、作用机制、研究对象、研究设计。分别检索。把它们合并成一条冗长的查询,正是得到 2400 万条结果的原因。
第 12–22 分钟:按成文标准筛选标题
在阅读任何内容之前,先写下三到四条纳入标准:研究对象、结局指标、研究设计、时间范围。然后逐条浏览结果,只根据标题和摘要标记“纳入”“排除”或“不确定”。有了标准,你就不会仅仅因为某篇论文有意思而把它留下。
第 22–30 分钟:给保留下来的论文排序
把纳入的论文排好顺序:直接回答你问题的放最前,其次是方法类论文,最后是背景文献。这就是你的阅读清单,而且每篇论文为什么在上面,你都说得清楚。
tlooto 能帮上什么
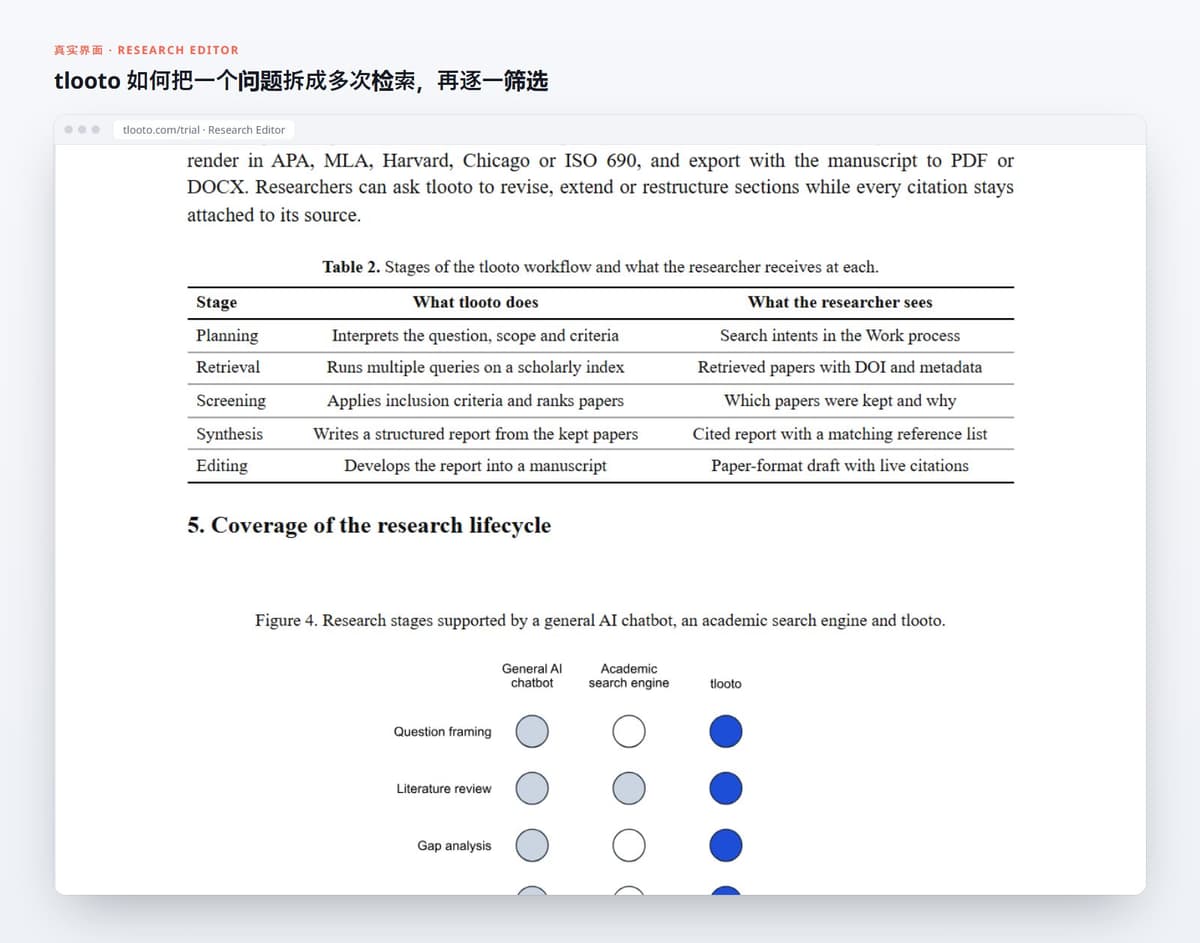
这套流程中机械性的部分,tlooto 可以替你完成。在报告视图中提出问题,它会把问题拆成互补的检索意图,针对每个意图在学术索引中运行多条查询,按明确的纳入标准筛选每篇候选论文,再基于通过筛选的论文撰写带引文的报告。整个计划都显示在“工作过程”面板中,检索了什么、为什么保留某篇论文,一目了然。
如果你更愿意亲自动手,论文搜索页会给出带摘要和引用数据的原始结果。在结果卡片上直接把论文保存到文库,下次需要时它就在那里。
参考文献
[1] Bornmann, L., Haunschild, R., & Mutz, R. (2021). Growth rates of modern science. Humanities and Social Sciences Communications, 8. https://doi.org/10.1057/s41599-021-00903-w