

tlooto AI Detector 页面上的示例分析,逐句展示检测结果。
想象收到这样一条消息:每一句都是我自己写的。检测器说 70% 是 AI 写的。教授要找我谈话。
这种处境非常糟糕,而且比想象中更常见。斯坦福大学的一项研究发现,七款常用的 GPT 检测器把非英语母语者撰写的 TOEFL 作文中超过一半误判为 AI 生成,而对英语母语者作文的判断则准确得多 [1]。严谨、正式、反复打磨过的英文,恰恰是学术写作所要求的,也恰恰是许多检测器觉得可疑的。
检测器到底在测什么
检测器并不知道文字是谁写的,它估算的是文本有多“可预测”。由常见措辞、工整结构和泛泛之论构成的句子,在统计上与模型输出很相似。所以像 These findings highlight the importance of adopting a holistic approach 这样的句子,不管是人写的还是模型写的都会被标记,因为它用一种非常熟悉的方式说了几乎等于没说的话。
这也是为什么单一的总体百分比只是很弱的证据。它掩盖了究竟是哪些句子推高了分数,以及原因何在。
被标记之后怎么办
- 看句子,别看分数。 找出被标记的是哪几句。在大多数人工撰写的稿件里,通常只是少数泛泛的过渡句和总结句。
- 用具体内容替换空泛表述。 把你的数据、样本、比较写进句子里。每天使用手机超过七小时的学生,第一学期 GPA 低 0.21 分 这样的句子,一看就出自真正做过分析的人。
- 保留写作过程的证据。 草稿、版本历史、笔记和数据文件,是你能拿出的最有力的作者身份证明。边写边存。
- 遵守所在机构的 AI 使用政策,并在要求时披露工具使用情况。 检测结果应当是一次对话的开始,而不是结论。
tlooto 的逐句分析
tlooto 的 AI Detector 逐句展示判断依据。每一句都会被标为 AI 写作信号、不确定或无异常,点击任一高亮句子即可查看它被标记的原因。之后你可以自己改写,也可以用 Humanizer 给出修改建议,然后再检测一次。
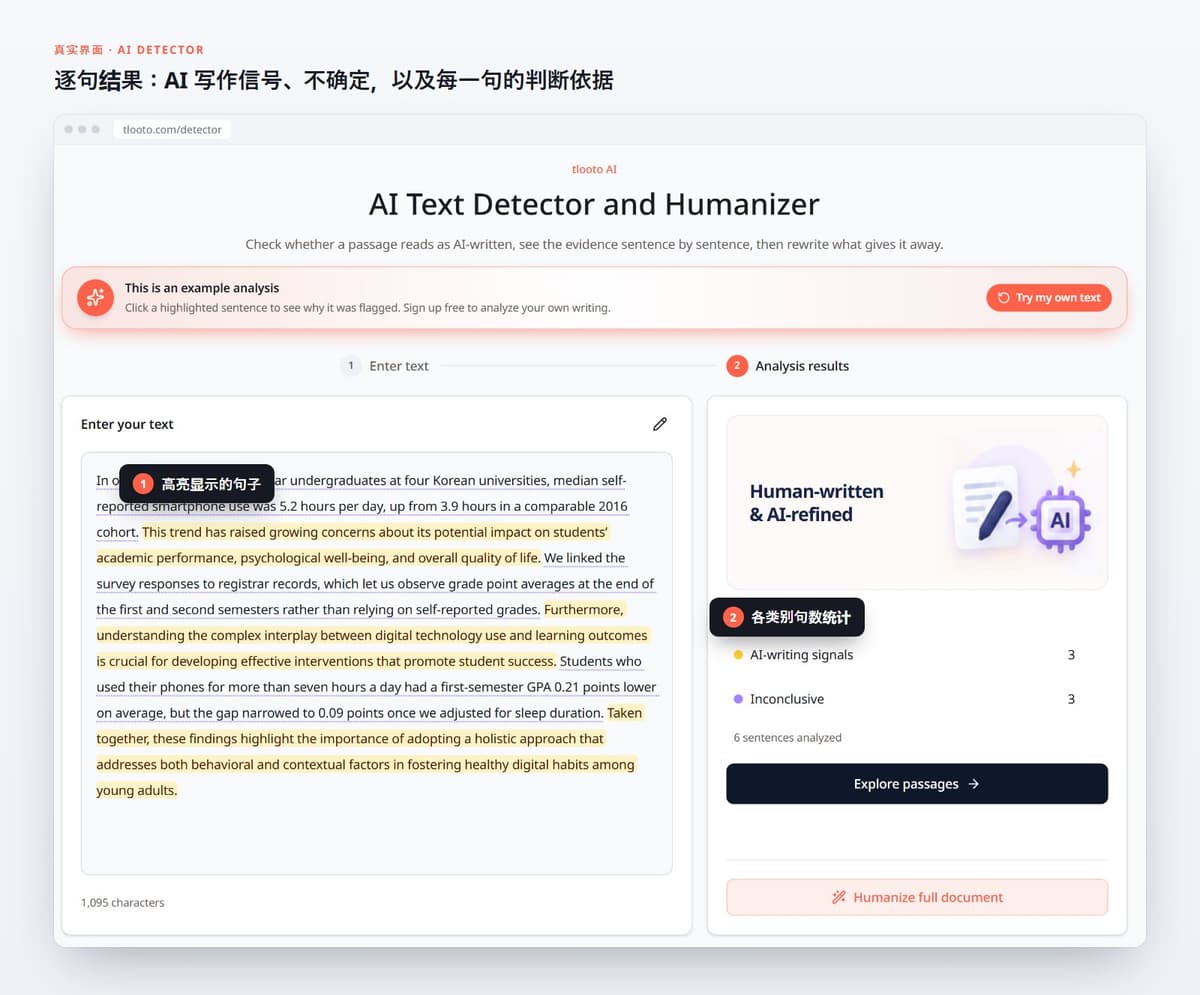
在检测器页面的示例中,被标记的都是泛泛之句:趋势陈述句、以 Furthermore 开头的那句,以及结尾的总结句。包含实际研究发现的句子都通过了。这种规律正是检测器能告诉你的最有用的信息,因为它指向的恰好是原本就最薄弱的句子。
参考文献
[1] Liang, W., Yuksekgonul, M., Mao, Y., Wu, E., & Zou, J. (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7). https://doi.org/10.1016/j.patter.2023.100779