

对于一篇规模不大的综述,四百篇摘要是很常见的数量。每篇一分钟,就是整整一个工作日,而没有人能连续八小时保持筛选质量。读到第 250 篇时,判断标准开始漂移;到第 350 篇,你会纳入早上本会排除的论文。
筛选不需要英雄主义,需要的是结构。
开始之前:把标准写下来
把四到五条纳入标准写成简短、可核对的陈述:研究对象、暴露或干预、结局、研究设计、时间范围。如果某条标准需要一段话来解释,就把它拆开。先用 20 篇摘要试筛,调整好再继续。
用三个选项,而不是两个
纳入、排除、不确定。“不确定”这一堆能让你保持节奏。大多数人把时间浪费在一篇篇纠结模棱两可的摘要上;把它们留到最后集中处理,更快也更一致。
每 50 篇一组
每组之间休息一下,开始新一组前重读一遍标准。听起来微不足道,却是防止判断漂移的最佳办法。
让 AI 做初筛,并给出理由
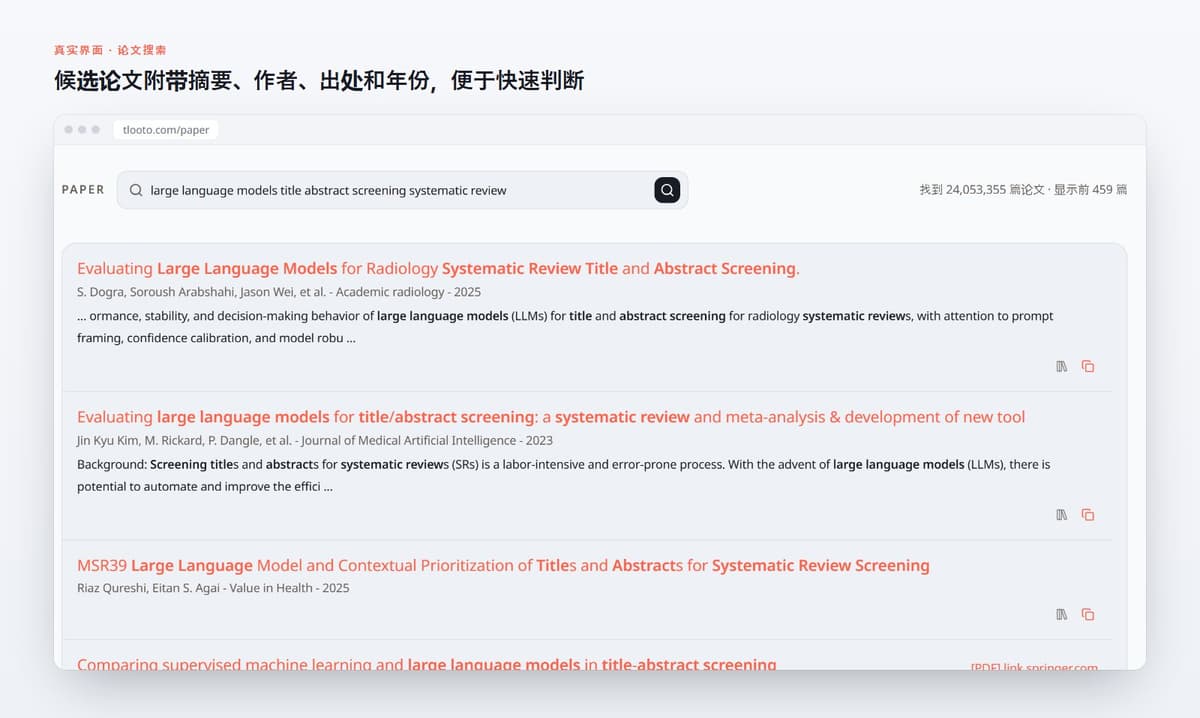
机器学习用于加速证据综合中的筛选已有多年 [1]。关键不在速度,而在可审核性。只有当你能看到每篇论文为何被保留或排除,并能亲自复核那些模棱两可的论文时,初筛才有用。
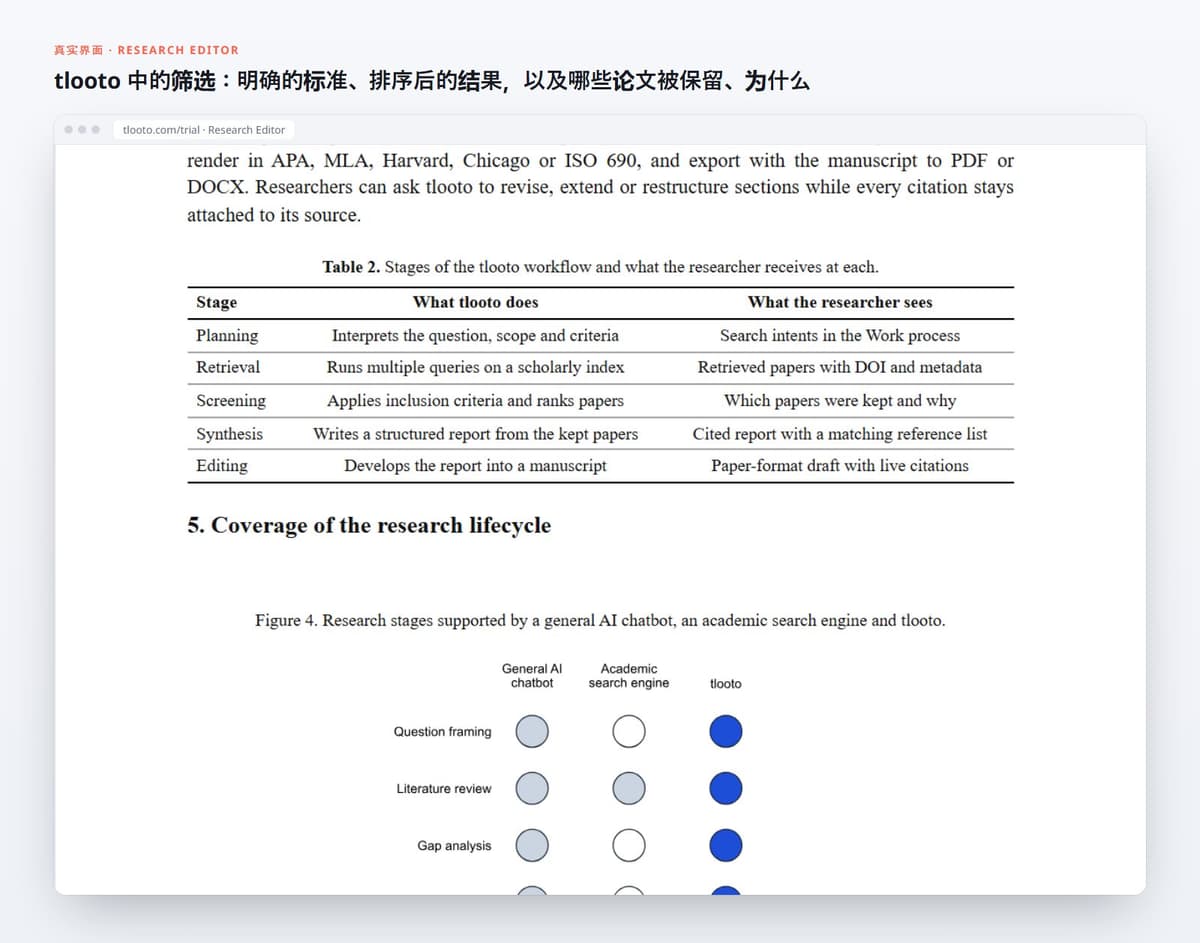
在 tlooto 中,每篇候选论文都会按照从你的问题中提炼出的明确纳入标准进行评估,与系统综述的筛选阶段一致。通过筛选的论文经过排序后,作为一个聚焦的证据集进入综合环节,“工作过程”面板会显示保留了哪些论文以及原因。
如果是正式的系统综述,请把它当作第二位审阅者或一个优先级排序步骤,而不是你研究方案的替代品。方法要求双人独立筛选的,继续双人筛选,并按照 PRISMA 2020 透明地报告 AI 辅助的使用情况。
拯救周末的检查清单
- 标准已写好,并用 20 篇摘要试筛过。
- 三个选项:纳入、排除、不确定。
- 每 50 篇一组,每组开始前重读标准。
- AI 初筛附带可见理由;由你复核“不确定”和模棱两可的论文。
- 记录每一条排除理由,用于绘制流程图。
参考文献
[1] Marshall, I. J., & Wallace, B. C. (2019). Toward systematic review automation: a practical guide to using machine learning tools in research synthesis. Systematic Reviews, 8. https://doi.org/10.1186/s13643-019-1074-9