

六项检查,两类工具。示意演示。
在《自然》对 1,600 多名研究者的调查中,许多人预计 AI 工具将对自己的工作变得重要甚至不可或缺 [1]。问题已不再是科研中要不要用 AI,而是当导师、审稿人或答辩委员问起某个论点是怎么得出的时,你能为使用哪款工具辩护。
这六个问题适用于任何工具,包括我们自己的。
1. 论点从何而来?
来自模型的记忆,还是来自为你的问题检索到的论文?只有后者可以核查。
2. 每条引文我都能打开吗?
每条参考文献都应能指向一篇真实的论文,最好带有 DOI。一项研究发现,GPT-3.5 给出的引文中有 55%、GPT-4 给出的引文中有 18% 是虚构的 [2]。打不开的,就不要引用。
3. 我能看到答案是如何得出的吗?
执行了哪些检索?保留了哪些论文,为什么?看得见的过程,才是你能写进方法部分的过程。
4. 它是按标准筛选,还是只按相关性排序?
按明确的纳入标准筛选,正是证据与搜索结果的分界线。
5. 写作时,证据是否始终与文字绑定?
如果把文字挪进文档的那一刻引文就断了,错误便会接踵而至。要选择起草环境中引文联动、支持标准引文格式的工具。
6. 追问能否建立在已有发现之上?
真实的研究问题总是一环扣一环。每次都从零开始的工具,浪费的是你的证据和你的时间。
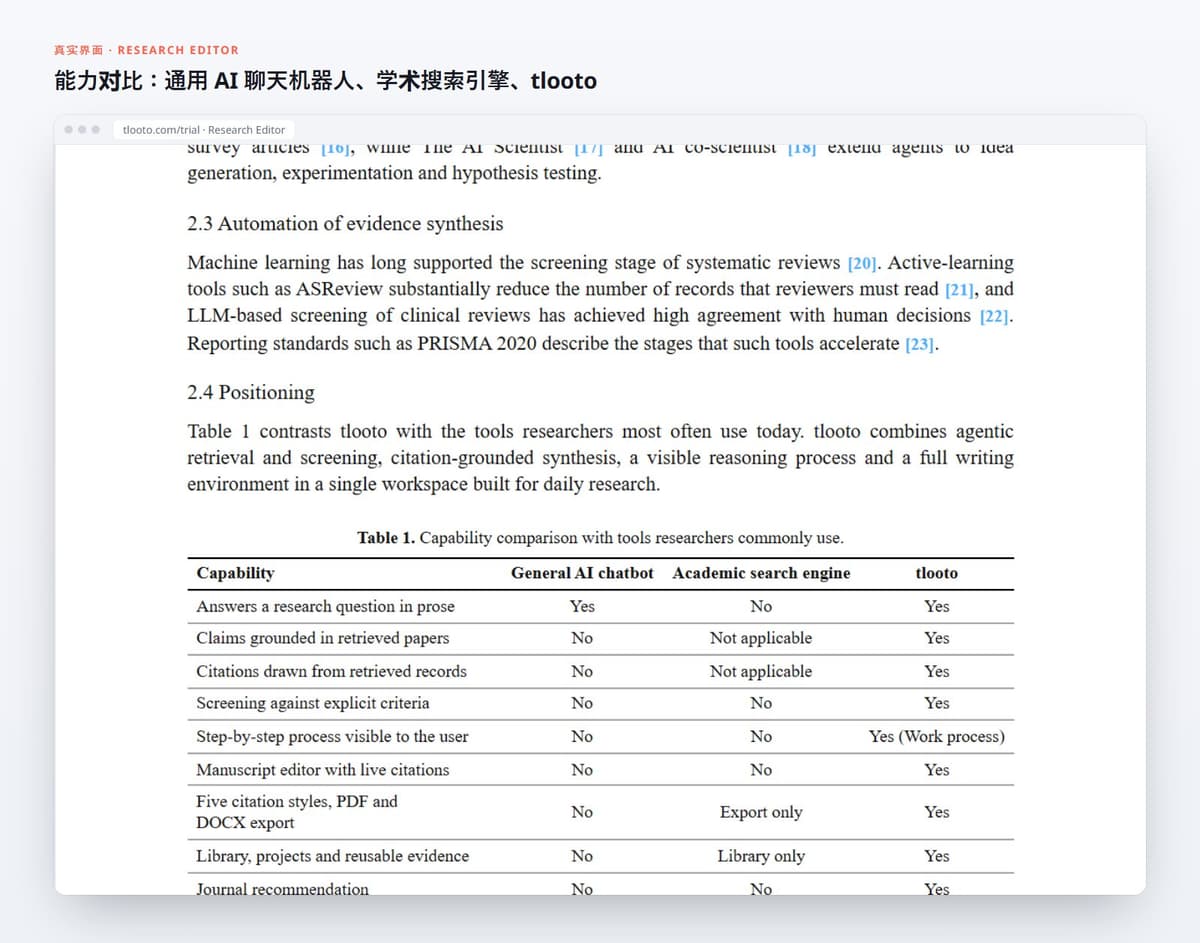
tlooto 正是围绕这六个问题设计的:检索到的论文附带 DOI,按你的标准筛选,“工作过程”全程可见,Research Editor 中引文联动,追问建立在已收集的证据之上。请用同样的标准来衡量它,以及你考虑的其他任何工具。
参考文献
[1] Van Noorden, R., & Perkel, J. M. (2023). AI and science: what 1,600 researchers think. Nature, 621. https://doi.org/10.1038/d41586-023-02980-0
[2] Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13. https://doi.org/10.1038/s41598-023-41032-5