tlooto: 学術合成と論文開発のための証拠に基づいたエージェントワークスペース
tlooto研究チーム
要約
背景。 学術文献は年間約 4% ずつ増加しており、1 回の系統的レビューには専門家の努力が 1 年以上かかります。大規模言語モデル (LLM) は救済を約束しますが、フロンティア モデルは生成される科学的引用のほとんどを捏造しており、検索ベースの商用ツールでさえクエリの最大 3 分の 1 で幻覚を起こします。
客観的。 私たちは、文献からの研究質問に答え、その答えを原稿に展開するリサーチ ワークスペースである tlooto を紹介します。このワークスペースは、すべての引用がその質問に対して検索された学術記録を指すように設計されています。
システム。 tlooto は、単一のエージェント ワークフローで、計画、学術検索、文献スクリーニング、証拠の合成および編集を調整します。各段階はその過程で研究者に示され、総合では審査に合格した論文のみから引用が抽出されます。
能力。 tlooto は、質問に答えるだけでなく、ライブ引用、表、図、方程式を 5 つの引用スタイルで表示できる論文形式のエディター、論文の直接検索、個人ライブラリとプロジェクトの記憶、ジャーナルの推奨機能を提供し、着想から投稿までの研究ライフサイクルをカバーします。
重要性。 tlooto は、引用の信頼性を、研究者が後で検証しなければならないものではなく、答えがどのように生成されるかという特性とし、新興クラスの研究エージェントを日常の学術研究のために設計された形式に持ち込みます。
キーワード: 研究エージェント。検索拡張生成。引用の根拠。証拠の総合。文献レビューの自動化。学術的な執筆
1. はじめに
1.1 文献の規模
科学的成果は 1 世紀以上にわたって継続的に増加してきました。ボルンマンら。現在の成長率は年間約 4.10% と推定され、倍増には約 17 年かかります。 [1]。臨床医学におけるプレッシャーはさらに厳しく、2010 年にはすでに約 75 件の試験と 11 件の系統的レビューが毎日発表されました。 [2] (図1)。この証拠を手作業で合成するには時間がかかり、コストがかかります。 PROSPEROに登録されたシステマティックレビューは、登録から公開まで平均67.3週間かかりました [3].
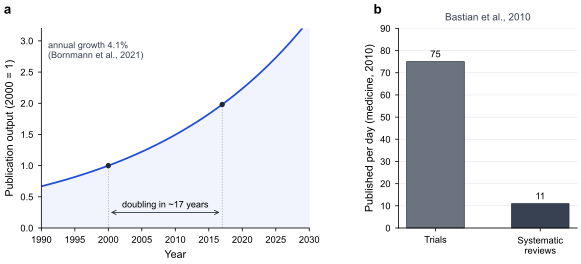
図 1. 科学文献の増加。 (a) 報告されている年間成長率 4.1%、つまり倍増期間約 17 年でモデル化された出版物の生産高。 (b) 2010 年に医学分野で 1 日あたりに発表された試験と系統的レビュー。
1.2 AI が研究現場に参入
研究者らはAIを採用することで対応した。 1,600 人を超える科学者を対象とした Nature 調査では、大多数が AI ツールが自分たちの分野にとって非常に重要または不可欠になると予想していました [4]、公開された記録の分析により、最近のコンピューター サイエンス論文の最大 17.5% に LLM で改変されたコンテンツが見つかった [5]。研究エージェントも急速に後を追い、科学的知識を総合しています [13] [14] [15]、調査記事の下書き [16]、専門家の査読者が人間のアイデアよりも斬新であると評価する研究アイデアを生み出す [19]、仮説の提案と検証を行います。 [17] [18].
1.3 信頼性のギャップ
ただし、汎用 LLM は、どのソースもサポートしていない流暢なステートメントを生成します。 [6]、そして引用は、この失敗が最も目に見えて最もコストがかかる場所です。 OpenScholar の評価では、GPT-4o が生成した科学引用文献の 78 ~ 90% が捏造されていました。 [15]。検索だけではギャップは埋まりません: 検索に基づいて構築された主要な商用調査ツールでも、依然としてクエリの 17 ~ 33% で幻覚が見られます [7] (図2)。研究者にとって、信頼できない引用は、まったく引用がないよりも悪いです。
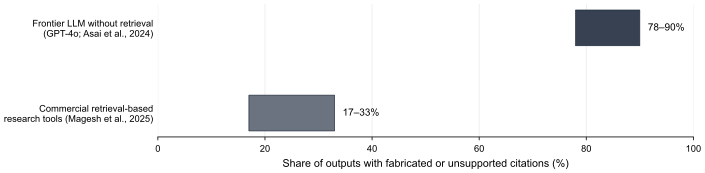
図 2. AI 研究支援の最近の評価において報告された、捏造または裏付けのない引用の割合。
1.4 貢献
この論文では、研究者が引用を信頼できるように構築されたシステムである tlooto について説明します。私たちの貢献は次のとおりです。
- 証拠に基づいた総合、この報告書では、当面の質問に関して検索され、選別された論文のみが引用されています(セクション 3)。
- エージェントリサーチのワークフロー 1 つの連続したプロセスで計画、検索、選別、合成、編集を行います (セクション 4)。
- 透明性のある作業プロセス これは、研究者に各計画、クエリ、スクリーニング決定、および中間結果をリアルタイムで表示します (セクション 4.4)。
- 統合された原稿環境 これにより、引用された証拠が完全な編集者に伝えられ、ジャーナルの選択に渡されます (セクション 5)。
2.関連作品
2.1 検索拡張と引用を意識した生成
検索拡張生成 (RAG) は、推論時にフェッチされたドキュメントに基づいて言語モデルを条件付けします。 [8] 知識集約的なタスクに対する主要なアプローチとなっています [9]。ガオら。各ステートメントをサポートする文章に引用を添付するようにモデルをプロンプトし、評価できることを示しました。 [10]。エージェントの処方により推論とツールの使用が交互に行われる [11]、思考の連鎖を促すことに基づく [12].
2.2 科学文献の調査エージェント
PaperQA は、科学的な質問に答えるために論文の全文を取得するエージェントを導入しました [13]、PaperQA2 は、ベンチマークで専門家のパフォーマンスを超える科学的知識の統合を報告しました。 [14]。 OpenScholar は、大規模なオープンアクセス コーパスと検索拡張モデルおよび自己フィードバックを組み合わせて、文献の質問に引用で答えます。 [15]。 AutoSurvey が完全な調査記事の下書きを作成します [16]一方、AI 科学者 [17] AI共同科学者 [18] エージェントをアイデア生成、実験、仮説検証まで拡張します。
2.3 証拠合成の自動化
機械学習は長い間、系統的レビューのスクリーニング段階をサポートしてきました。 [20]。 ASReview などのアクティブ ラーニング ツールにより、レビュー担当者が読まなければならないレコードの数が大幅に削減されます [21]臨床レビューの LLM ベースのスクリーニングは、人間の決定と高い一致を達成しています。 [22]。 PRISMA 2020 などの報告基準には、そのようなツールが加速する段階が記載されています [23].
2.4 位置決め
表 1 は、tlooto と研究者が現在最もよく使用しているツールを対比しています。 tlooto は、エージェントによる検索とスクリーニング、引用に基づく合成、目に見える推論プロセス、および完全な執筆環境を、日々の研究のために構築された単一のワークスペースに組み合わせています。
表1. 研究者が一般的に使用するツールとの機能の比較。
| 能力 |
一般的なAIチャットボット |
学術検索エンジン |
tlooto |
| 研究の質問に散文で答えます |
はい |
いいえ |
はい |
| 回収された論文に基づく主張 |
いいえ |
該当なし |
はい |
| 取得した記録から抽出された引用 |
いいえ |
該当なし |
はい |
| 明示的な基準に照らしてスクリーニングする |
いいえ |
いいえ |
はい |
| ユーザーに見える段階的なプロセス |
いいえ |
いいえ |
はい(作業工程) |
| ライブ引用を備えた原稿エディタ |
いいえ |
いいえ |
はい |
| 5 つの引用スタイル、PDF および DOCX エクスポート |
いいえ |
輸出のみ |
はい |
| ライブラリ、プロジェクト、再利用可能な証拠 |
いいえ |
図書館のみ |
はい |
| 雑誌の推薦 |
いいえ |
いいえ |
はい |
3. 証拠に基づいた総合
しましょう $q$ リサーチクエスチョンを表します。 tlooto は一連の検索クエリを発行します $Q(q)$ 取得したレコードを収集します
$$R(q) = \bigcup_{k \in Q(q)} \operatorname{retrieve}(k)$$
スクリーニングには包含基準が適用されます $\phi$ 質問から導き出され、証拠が揃った状態に保たれます
$$E(q) = {, r \in R(q) : \phi(r, q) = 1 ,}$$
報告書 $A$ 一連のステートメントとして記述されます $s_1, \dots, s_n$、それぞれに引用セットが含まれます $c(s_i)$。 tlooto はグラウンディングの原理に基づいて設計されています
$$\bigcup_{i=1}^{n} c(s_i) ;\subseteq; E(q) ;\subseteq; R(q)$$
そのため、レポートの参考文献リストは、回答が書かれたのと同じ学術的記録から構築されます。なぜなら、すべてのレコードが $R(q)$ DOI と書誌メタデータを含む学術索引から取得されており、tlooto レポート内の引用は、存在する論文につながり、研究者はそれを開くことができます。
4. tlooto ワークフロー
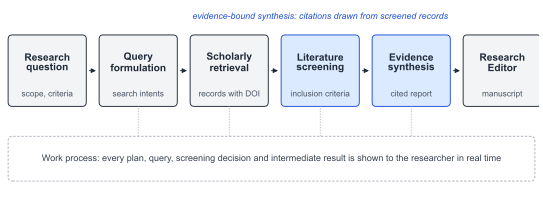
図 3. 研究質問から原稿までの tlooto ワークフロー。スクリーニングと合成が強調表示されます。作業プロセスにより、すべての段階が研究者に見えるようになります。
4.1 計画と学術検索
tlooto はまず、研究者が提供する範囲、専門分野、包含基準とともに質問を解釈し、それを補完的な検索意図に分割します。単一のクエリを発行するのではなく、学術インデックスに対してインテントごとに再定式化された複数のクエリを実行し、結果をマージします。取得されたすべてのレコードには、著者、会場、年、要約、DOI が含まれています。
4.2 文献審査
各候補者は、系統的レビューのスクリーニング段階を反映して、質問から引き出された明確な選択基準に基づいて評価されます。 [20] [21] [22] [23]。合格した論文はランク付けされ、検索結果の生のリストではなく、焦点を絞った証拠セットとして総合に渡されます。
4.3 証拠の統合
レポートは審査された論文に基づいて作成されます。各ステートメントには引用番号が付けられ、参考文献リストは同じレコードから生成されるため、本文と参考文献は常に一致します。追加質問はすでに収集された証拠に基づいて行われるため、調査は再開されるのではなく、さらに深まります。
4.4 作業プロセス
すべての計画、クエリ、スクリーニング決定、および中間結果は、作業プロセス パネルの研究者にストリーミングされます。研究者は、何が検索され、どの論文が保管され、回答がどのように組み立てられたかを確認し、システムの推論を独自の方法で追跡および引用できる記録に変えることができます。
4.5 リサーチエディター
ワンアクションでレポートが Research Editor で開きます。Research Editor は、見出し、表、図、方程式、およびライブ引用オブジェクトをサポートする論文形式のエディターです。テキストの移動に応じて引用番号が自動的に付け直され、APA、MLA、ハーバード、シカゴ、または ISO 690 でレンダリングされ、原稿と一緒に PDF または DOCX にエクスポートされます。研究者は、すべての引用を出典に添付したままにして、tlooto にセクションの改訂、拡張、または再構成を依頼できます。
表 2. tlooto ワークフローの各段階と研究者が各段階で受け取るもの。
| ステージ |
tlootoがすること |
研究者が見ているもの |
| 企画 |
質問、範囲、基準を解釈する |
作業プロセスでの検索意図 |
| 検索 |
学術インデックスに対して複数のクエリを実行します。 |
DOI とメタデータを含む論文を取得 |
| スクリーニング |
包含基準を適用して論文をランク付けします |
どの書類が保管されていたのか、またその理由は |
| 統合 |
保管されている書類から構造化されたレポートを作成します |
一致する参考文献リストを含む引用レポート |
| 編集 |
レポートを原稿に発展させます |
ライブ引用を含む紙形式のドラフト |
5. 研究ライフサイクルの範囲
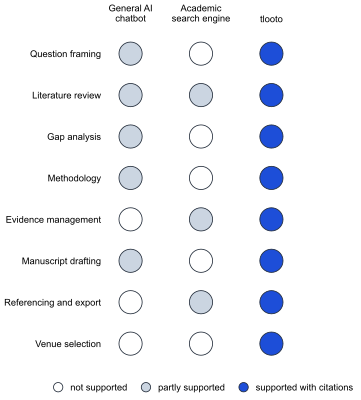
図 4. 一般的な AI チャットボット、学術検索エンジン、tlooto によってサポートされる研究段階。
tlooto は、単一目的のツールではなく、プロジェクト全体の 1 つのワークスペースとして設計されています (図 4、表 3)。質問、保存された論文、アップロードされたファイルはプロジェクトとライブラリに蓄積されるため、新しい検索を開始するのではなく、後の質問は以前の証拠に基づいて構築されます。
表 3. tlooto によってサポートされる研究タスク。
| 研究課題 |
tlooto が提供するもの |
どこで |
| 研究の質問を組み立てる |
候補となる質問と理論的観点と裏付けとなる文献 |
レポート |
| 文献レビュー |
完全に引用された視点、合意、議論の地図 |
レポート、論文検索 |
| ギャップ分析 |
未開拓の領域とそれを定義する証拠 |
レポート |
| 方法論 |
それらを使用した研究に関連した設計、測定、および分析 |
レポート |
| 証拠管理 |
保存された論文、アップロードされたファイル、再利用可能な証拠 |
私のライブラリ、プロジェクト |
| 原稿作成 |
ライブ引用、表、図、方程式を含む紙形式のドラフト |
リサーチエディター |
| 参照する |
5 つの引用スタイル、自動再番号付け、PDF および DOCX エクスポート |
リサーチエディター |
| 会場の選択 |
原稿に合わせた雑誌の推奨事項 |
AI Journal Finder |
表4. 質問の例と tlooto が作成するレポートの構成。
| 質問の種類 |
質問例 |
レポートの構造 |
| 研究課題 |
知識を変える生成 AI は専門組織でどのように機能していますか? |
視点、候補となる質問、裏付けとなる研究 |
| 研究ギャップ |
組織における AI 導入に関する研究でまだ解明されていないことは何でしょうか? |
ギャップ、それぞれが重要な理由、それに対処する方法 |
| 文献レビュー |
プラットフォーム エコシステム ガバナンスの研究は 5 年間でどのように進化しましたか? |
テーマ、合意、議論、軌跡 |
| エビデンス |
AI投資は企業の業績を向上させるのか? |
支持する調査結果と矛盾する調査結果、モデレーター |
| 方法論 |
心理的安全性は AI の導入と仕事の満足度を仲介しますか? |
設計、対策、サンプリング、分析計画 |
6. ディスカッション
tlooto における中心的な設計上の決定は、引用の根拠を、後で適用されるチェックとしてではなく、回答を生成する方法の一部として扱うことです。検索ベースの商用ツールの評価では、検索だけでは依然としてかなりのエラーが残ることが示されています [7]; tlooto は明示的なスクリーニングを追加し、スクリーニングされた論文から各レポートの参照を作成します。また、プロセス全体が公開されるため、研究者はすべての結論にどのように到達したかを確認できます。
2 番目の決定は統合です。研究エージェントは、機械が専門家レベルで文献を合成できることを示しました [14] [15] 強力な研究アイデアを生み出す [19]しかし、研究者の仕事は答えを出して終わるわけではありません。 tlooto は証拠を原稿に直接取り込み、改訂中も引用を維持し、ジャーナルの選択をサポートします。そのため、検索と審査で節約された時間が、フォーマットと参照で再び失われることはありません。
これらの選択により、tlooto はセクション 1 で説明した作業量の実際的な研究パートナーになります。つまり、広く読み、忠実に引用し、学問が必要とする形式で執筆するものです。
7. 結論
現在、文献は研究者が読み切れないほどのスピードで増えており、汎用 AI はまだ文献を信頼できません。 tlooto は、エージェント ワークスペースで両方の問題に対処します。エージェント ワークスペースは、執筆前に取得してスクリーニングし、保持している論文からすべての参考文献リストを作成し、作業を段階的に示し、結果を 1 つのワークスペース内で原稿に展開します。