

tlooto 논문 검색에 평범한 검색어를 넣어 봤습니다. large language models title abstract screening systematic review. 결과는 24,053,355건이었습니다. 첫 페이지는 관련이 있었습니다. 다섯 번째 페이지도 그랬습니다. 바로 그게 함정입니다.
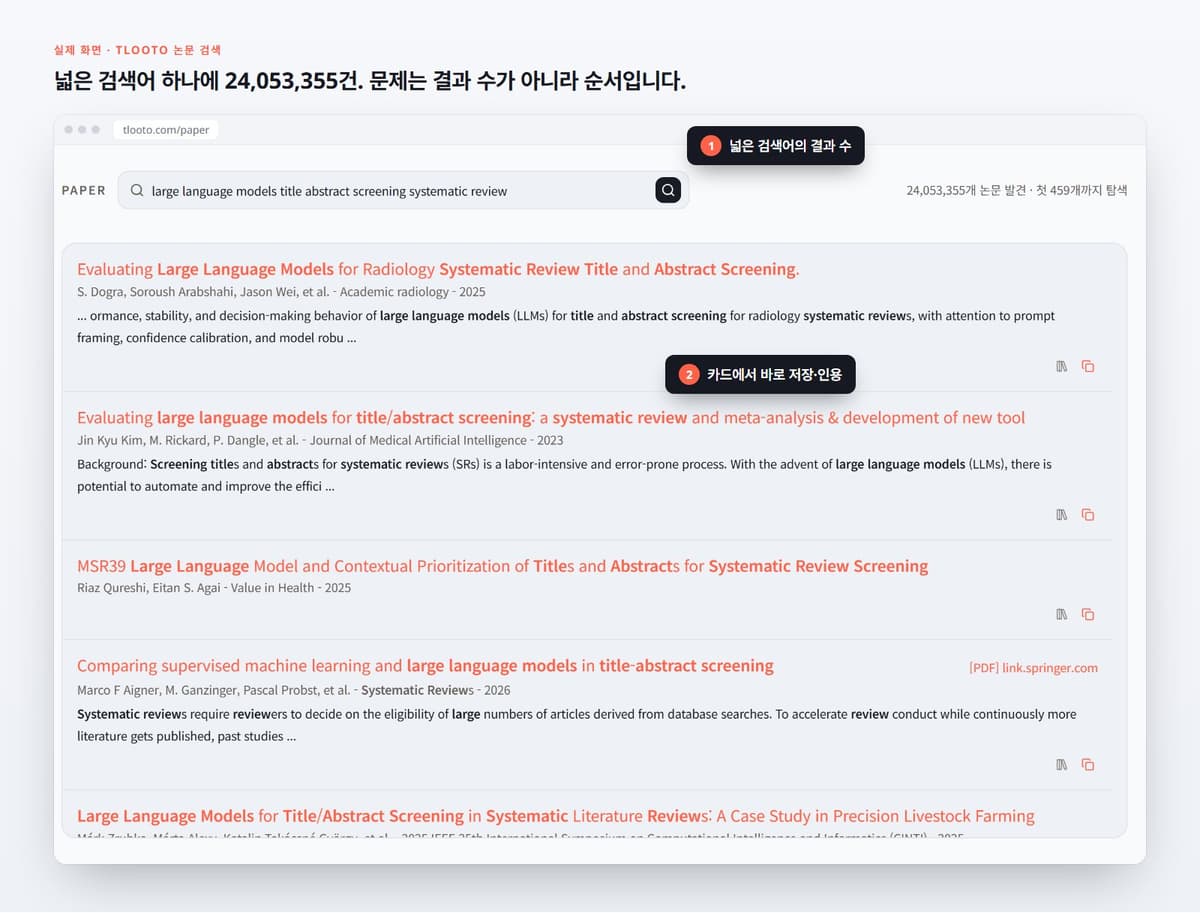
모든 결과가 관련 있어 보이면 사람들은 둘 중 하나를 합니다. 상위 10개만 읽고 멈추거나, 탭 40개를 열어 놓고 오후를 날리거나. 어느 쪽도 지도교수에게 근거를 댈 수 있는 읽기 목록이 되지 못합니다. 과학 문헌은 해마다 약 4.1%씩 늘어 대략 17년마다 두 배가 되니 [1], 저절로 나아질 일도 아닙니다.
저희가 권하는 루틴은 이렇습니다. 30분 정도 걸립니다.
0~5분: 질문을 한 문장으로 쓰기
주제가 아니라 질문이어야 합니다. 대상, 노출 요인이나 방법, 결과가 들어간 질문이요. How does nightly smartphone use relate to GPA in undergraduates, and does sleep explain part of it?(대학생의 야간 스마트폰 사용은 학점과 어떤 관계가 있으며, 수면이 그 일부를 설명하는가?)는 검색할 수 있는 질문입니다. Smartphones and students(스마트폰과 학생)는 그렇지 않습니다.
5~12분: 서너 개의 검색 의도로 나누기
검색 의도 하나가 질문의 한 측면을 맡습니다. 핵심 관계, 작동 기제, 대상 집단, 연구 설계. 각각 따로 검색하세요. 이걸 하나의 긴 검색어로 합치면 결과가 2,400만 건이 됩니다.
12~22분: 적어 둔 기준으로 제목 선별하기
무엇이든 읽기 전에 포함 기준을 서너 개 적어 두세요. 대상, 결과 측정 방법, 연구 설계, 기간. 그런 다음 결과 목록을 따라 내려가며 제목과 초록만 보고 포함, 제외, 보류로 표시합니다. 기준이 있으면 단지 흥미롭다는 이유로 논문을 남겨 두지 않게 됩니다.
22~30분: 남은 논문에 순위 매기기
포함한 논문을 순서대로 정리합니다. 질문에 직접 답하는 논문을 맨 앞에, 그다음 방법론 논문, 그다음 배경 논문. 이것이 읽기 목록이고, 목록에 있는 논문 하나하나가 왜 거기 있는지 설명할 수 있습니다.
tlooto가 맡는 부분
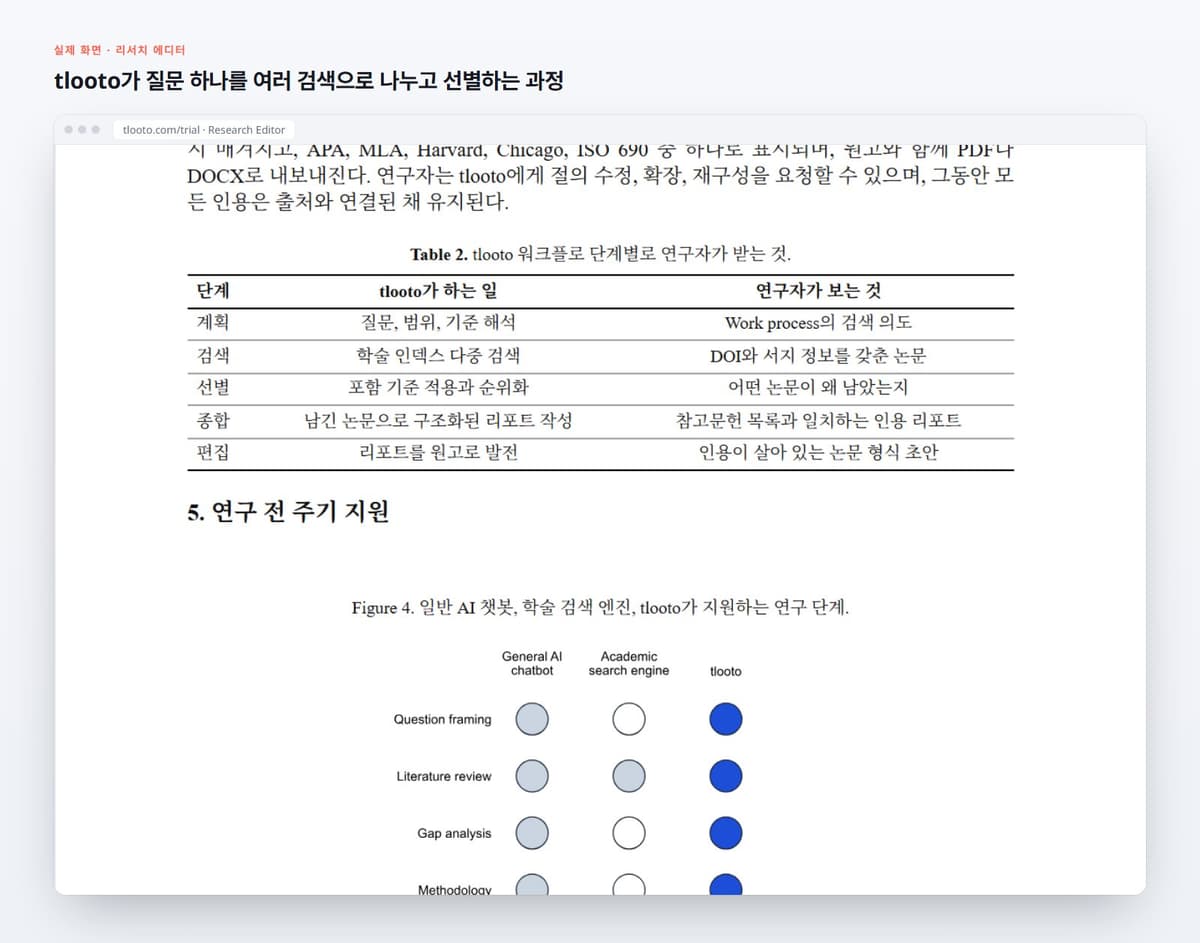
tlooto는 이 루틴의 기계적인 부분을 대신합니다. 리포트 화면에서 질문하면 서로 보완하는 검색 의도로 나누고, 의도마다 학술 색인에 여러 검색어를 실행하고, 후보 논문을 명시적인 포함 기준으로 하나씩 선별한 뒤, 통과한 논문으로 인용이 달린 리포트를 작성합니다. 전체 계획이 작업 과정 패널에 표시되므로 무엇을 검색했고 왜 그 논문을 남겼는지 확인할 수 있습니다.
직접 챙기는 쪽이 편하다면 논문 검색 페이지에서 초록과 인용 데이터가 포함된 원래 결과를 볼 수 있습니다. 결과 카드에서 바로 라이브러리에 저장해 두면 다음에 필요할 때 그대로 꺼내 쓸 수 있습니다.
참고문헌
[1] Bornmann, L., Haunschild, R., & Mutz, R. (2021). Growth rates of modern science. Humanities and Social Sciences Communications, 8. https://doi.org/10.1057/s41599-021-00903-w